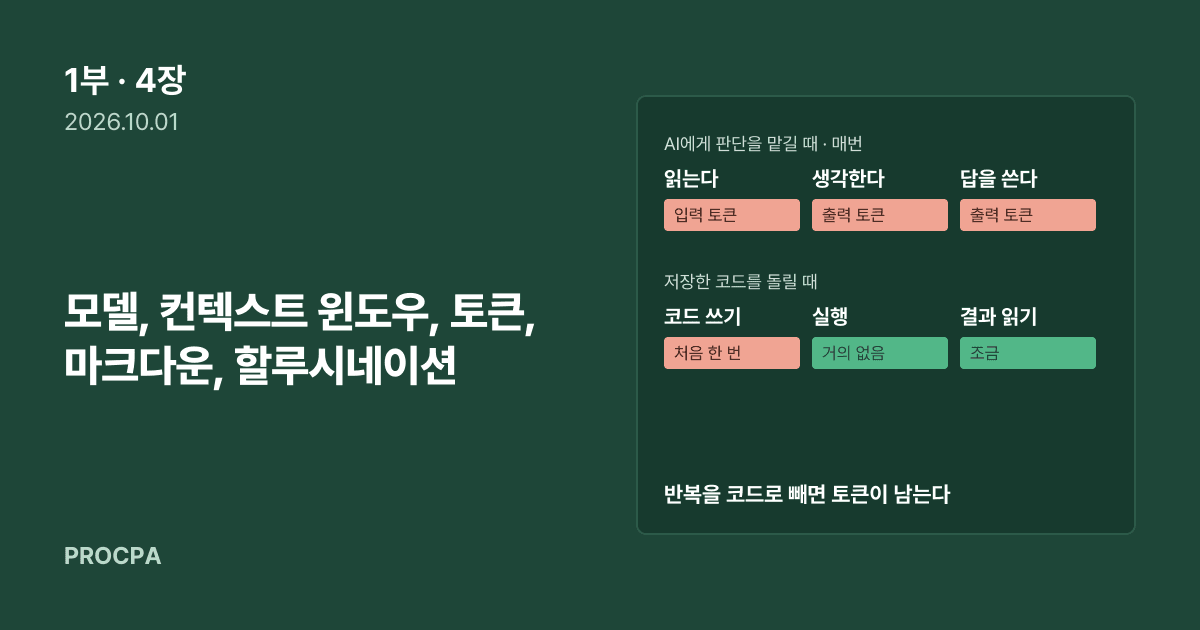
4장. 모델, 컨텍스트 윈도우, 토큰, 마크다운, 할루시네이션
세 재료를 실제로 쓰면 매일 부딪히는 다섯 용어(모델·컨텍스트 윈도우·토큰·마크다운·할루시네이션)를 재료와 연결해 정리하고, 에이전트에게 남은 두 한계를 클로드 코드로 채우는 이유로 마무리합니다.
세 재료를 쓰기 시작하면 만나는 다섯 가지
3장에서 본 컨텍스트와 프롬프트, 코드를 들고 실제로 월 결산 자료를 정리해 보면, 화면 곳곳에서 낯선 말을 만나게 됩니다. 입력창 옆에는 Opus니 Sonnet이니 하는 이름이 적힌 선택 칸이 있고, 대화를 길게 이어 가다 보면 답이 점점 흐려지며, 어느 날은 사용 한도가 얼마 남지 않았다는 안내가 뜹니다. 작업 폴더에는 .md로 끝나는 파일이 생기고, AI가 자신 있게 인용한 기준서 문단을 찾아보니 그런 문단이 아예 없기도 합니다.
이 장에서 다룰 다섯 용어가 바로 이것들입니다. 모델은 판단의 품질과 비용을 고르는 일이고, 컨텍스트 윈도우는 한 번에 넘길 수 있는 컨텍스트의 양이며, 토큰은 판단할 때마다 드는 사용량입니다. 마크다운은 프롬프트를 담는 형식이고, 할루시네이션은 근거 없이 판단할 때 생기는 틀린 답입니다.
모델 이름과 순위는 몇 주 만에 바뀌므로 이 장의 숫자는 모두 2026년 10월 기준으로 적었습니다. 숫자 자체보다는 무엇을 기준으로 고르고 아끼는지를 중심으로 읽어 주시면 됩니다.
모델: 앱 안에서 생각하는 두뇌를 고른다
모델(Model)은 AI 회사가 데이터를 학습시켜 내놓은 AI 그 자체, 곧 AI의 두뇌입니다. 웹 문서와 책, 뉴스, 코드 같은 데이터를 데이터센터에서 몇 달 동안 학습시킨 결과가 모델이며, 앤트로픽의 Fable·Opus·Sonnet이 모두 모델 이름입니다.
여기서 자주 헷갈리는 것이 앱과 모델의 차이입니다. ChatGPT, 클로드, 제미나이는 앱, 곧 서비스 이름이고, 그 앱 안에서 실제로 생각하고 답을 쓰는 두뇌가 모델입니다. 같은 앱이어도 입력창 옆의 모델 선택 칸에서 모델을 바꾸면 답의 수준과 속도, 비용이 달라집니다. 따라서 모델을 고르는 일은 곧 AI에게 맡기는 판단의 품질과 비용을 고르는 일입니다.
몇 달 학습
가져와 쓴다
어떤 등급을, 얼마나 깊게 생각하게 할까
실무에서 우리가 고를 것은 두 가지입니다. 어떤 등급의 모델을 쓸지, 그리고 그 모델에게 얼마나 깊게 생각하게 할지입니다.
상위 모델은 두뇌가 더 크고 더 많은 데이터로 오래 학습해 복잡한 판단에 강하지만, 느리고 비쌉니다. 경량 모델은 두뇌를 작게 만들어 빠르고 쌉니다. 2026년 10월 기준으로 클로드의 상위 모델은 Fable 5.1(최상위)과 Opus 5.5, 표준 모델은 Sonnet 5.5, 경량 모델은 Haiku 4.5입니다.
추론 수준은 같은 모델에게 얼마나 깊게 생각하게 할지를 고르는 설정으로, 앱에서는 '생각 모드'나 '추론 강도' 같은 이름으로 들어 있습니다. 높게 두면 답하기 전에 스스로 따져 보느라 느려지고, 그 생각도 모두 비용이 됩니다.
빠르고 싸게 끝낸다회계 판단 · 복잡한 수식 설계
느리고, 생각도 모두 비용
이 때문에 요약·분류·서식 정리는 표준이나 경량 모델에 낮은 추론으로 맡기고, 회계 판단이나 복잡한 수식 설계처럼 따져 봐야 하는 일만 상위 모델에 높은 추론으로 맡깁니다. 대부분의 작업은 표준 모델로 충분하고, 응답이 빨라 일의 흐름이 끊기지 않으니 오히려 나을 때가 많습니다.
시험 점수로 보는 모델: 회사와 벤치마크
모델을 만드는 회사는 많지만 먼저 기억할 곳은 앤트로픽(클로드), 오픈AI(ChatGPT), 구글(제미나이) 세 곳입니다. 메타와 xAI, 중국의 GLM·Kimi·DeepSeek 등도 바짝 따라오고 있습니다.
모델끼리 실력을 비교하는 기준은 벤치마크(Benchmark)입니다. 정해진 문제 세트로 모델을 채점한 시험 점수입니다. 독립 평가 기관 Vals AI가 회계·재무 분야에서 치른 두 시험의 순위와 정답률은 다음과 같습니다.
표 3-1. 회계·재무 벤치마크 순위와 정답률 (Vals AI, 2026년 10월 기준, 10월 4일 조회)
| 모델 | 엑셀 재무모델링 | 세무 리서치 |
|---|---|---|
| Claude Fable 5.1 | 1위, 76.7% | 1위, 77.6% |
| Claude Opus 5.5 | 2위, 75.9% | 9위, 70.5% |
| Claude Sonnet 5.5 | 3위, 75.7% | 4위, 73.4% |
| Gemini 4 Argon | 4위, 75.2% | 2위, 76.2% |
| GPT-6 Astra | 9위, 71.7% | 24위, 63.3% |
엑셀 재무모델링은 IB·PE 주니어 수준의 재무모델을 엑셀로 만드는 시험, 세무 리서치는 법령을 찾아 법인세 문제에 답하는 시험이며, 순위는 각 시험의 전체 순위입니다.
이 표에서 읽어 낼 것은 두 가지입니다. 첫째, 같은 클로드라도 Opus 5.5는 엑셀 재무모델링 2위, 세무 리서치 9위여서 시험마다 잘하는 모델이 다릅니다. 둘째, 무엇보다 1위 모델도 정답률이 70%대입니다. 나머지는 사람이 검증해야 한다는 뜻입니다.
추론 수준의 차이도 점수로 드러납니다. Artificial Analysis의 종합 점수에서 같은 Opus 5.5가 추론 수준을 가장 높게 두면 58점, 가장 낮게 두면 42점이었습니다(2026년 10월 기준, 10월 4일 조회). 깊게 생각할수록 점수도 비용도 함께 올라갑니다.
국내에도 LG AI연구원의 엑사원(EXAONE), 네이버의 하이퍼클로바X(HyperCLOVA X), 업스테이지의 솔라(Solar) 같은 '소버린 AI'가 있습니다. 망분리 같은 규제로 재무 데이터를 해외 서버에 보낼 수 없는 회사라면 검토해 볼 만합니다.
컨텍스트 윈도우: 한 번에 넘길 수 있는 양에는 한도가 있다
컨텍스트 윈도우(Context Window)는 AI가 한 대화에서 한 번에 기억하는 양, 곧 한 번에 넘길 수 있는 컨텍스트의 용량입니다. 2022년 말 ChatGPT가 처음 나왔을 때는 4천 토큰 정도로 A4 몇 장 분량이었지만, 지금은 100만 토큰, 책 여러 권 분량까지 커졌습니다. 3장에서 본 파일 첨부가 가능해진 것도 이 덕분입니다.
하지만 한도가 크다고 꽉 채워 쓰면 두 가지 문제가 함께 커집니다.
- 답변 품질 저하: 지금 작업과 상관없는 정보와 맥락이 쌓이면 답이 흐려지고 틀린 답이 늘어납니다.
- 토큰 소모 증가: 질문 한 줄을 해도 AI는 앞의 대화와 첨부까지 다시 읽기 때문에, 쌓인 맥락만큼 사용량이 늘어납니다.
A4 몇 장약 4천 토큰
책 여러 권100만 토큰
따라서 컨텍스트는 판단에 필요한 만큼만 넘기는 편이 좋습니다. 3장에서 본 작업 폴더와 스킬도 이 원리로 일합니다. 클로드 코드는 폴더의 자료를 미리 통째로 읽어 두지 않고 일에 필요한 파일만 찾아 읽으며, 스킬도 평소에는 이름과 한 줄 설명만 알고 있다가 필요할 때 본문을 펼쳐 읽습니다.
우리 쪽에서 할 일도 있습니다. 새로운 작업은 새 대화창에서 시작하고, 같은 일을 길게 이어 갈 때는 주기적으로 /compact 명령으로 지난 대화를 요약해 용량을 비웁니다. 클로드 코드에서는 새 대화창을 '새 세션'이라고 부릅니다.
토큰: AI 사용량을 재는 단위
토큰(Token)은 AI가 글을 읽고 쓰는 조각 단위이자 AI 사용량을 재는 단위입니다. 예를 들어 "대손충당금을 설정합니다"는 대, 손, 충당, 금, 을, 설정, 합, 니다처럼 8개 조각으로, "Set the allowance"는 3개 조각으로 나뉠 수 있습니다. 쪼개는 방식은 모델마다 다르지만, 같은 뜻이어도 한국어는 보통 영어보다 1.5배에서 2배 더 잘게 쪼개집니다.
전기를 kWh로 재듯 AI는 토큰으로 사용량을 잽니다. 앞에서 본 컨텍스트 윈도우도, API 요금도, 구독 한도도 모두 토큰 단위입니다.
판단에는 매번 들고, 코드 실행에는 거의 들지 않는다
토큰은 AI가 글을 읽을 때와 쓸 때 듭니다.
- 입력(읽을 때): 내 질문과 첨부 파일, AI가 스스로 찾아 읽은 파일을 읽을 때 듭니다.
- 출력(쓸 때): 답변과 코드를 쓸 때, 그리고 답하기 전에 생각할 때 듭니다. 화면에 뜨는 '생각 중…'도 AI가 보이지 않는 연습장에 풀이를 적는 과정입니다.
같은 토큰이라도 출력이 입력보다 5배 비쌉니다(2026년 10월 기준, 앤트로픽 API 가격표). 또 같은 내용이어도 PDF로 주면 몇 배, 이미지나 스캔본은 몇 배에서 수십 배가 듭니다. 앤트로픽 공식 비전 문서 기준으로 1920×1080 화면 캡처 한 장이 약 2,700토큰입니다.
이 구조를 서론의 전략에 대어 보면 흥미로운 점이 보입니다. AI에게 판단을 맡길 때는 자료를 읽고, 생각하고, 답을 쓰는 만큼 매번 토큰이 듭니다. 하지만 저장한 코드를 컴퓨터가 실행하는 동안에는 토큰이 거의 들지 않습니다. AI가 코드를 쓰고 실행 결과를 읽을 때만 토큰이 들고, 수만 줄의 계산은 컴퓨터가 하기 때문입니다.
반복을 코드로 빼 두면 그만큼 아낀 사용량을 판단에 쓸 수 있습니다. 구독 요금제도 무제한이 아니어서, 클로드에는 5시간마다 초기화되는 한도와 주간 한도가 있습니다. 긴 대화와 큰 첨부, 상위 모델, MCP 같은 커넥터를 많이 쓸수록 빨리 닳습니다.
토큰을 아끼는 네 가지 원칙
지금까지 본 개념을 합치면 토큰을 아끼는 방법은 네 가지로 정리됩니다.
- 이미지보다 텍스트로 넘긴다: 이미지와 스캔본은 같은 내용의 텍스트보다 몇 배에서 수십 배의 입력 토큰이 듭니다(3장의 멀티모달).
- 일상 작업은 가벼운 모델과 낮은 추론으로 한다: 상위 모델은 단가가 높고, 답하기 전의 생각도 출력 토큰입니다(모델).
- 새로운 작업은 새 대화창에서 한다: 질문할 때마다 앞 대화 전체를 처음부터 다시 읽습니다(컨텍스트 윈도우).
- 반복되는 작업은 코드로 고정한다: 코드를 쓰고 결과를 읽을 때만 토큰이 들고, 계산은 컴퓨터가 합니다(코드).
가장 강력한 방법은 네 번째입니다. 반복 작업은 매번 AI에게 시키지 말고 "코드로 만들어서 실행해 줘"라고 하면 됩니다. 이 네 가지만 지켜도 대부분의 실무 자동화는 기본 유료 요금제로 할 수 있습니다.
마크다운: 프롬프트를 담는 형식
마크다운(Markdown)은 #, **, - 같은 기호로 서식을 표시하는 글쓰기 형식이며, 마크다운 파일의 확장자는 .md입니다. 챗봇 답변에서 제목이 크게, 중요한 단어가 굵게 나오는 것도 AI가 기호를 넣어 쓴 글을 화면이 서식으로 바꿔 보여 준 결과입니다.
마크다운은 프롬프트를 담는 형식이기도 합니다. 사람도 AI도 읽기 쉬워서 AI 도구 대부분이 이 형식을 씁니다. 3장에서 본 CLAUDE.md와 스킬의 SKILL.md도 클로드 코드가 정해 둔 공식 파일 이름이고, 내용은 마크다운입니다. 예를 들어 회계팀 작업 폴더의 규칙을 적은 CLAUDE.md는 이렇게 생겼습니다.
# 회계팀 작업 폴더 규칙
## 폴더
- 01_받은자료는 원본이다. 읽기만 하고 **고치지 않는다**
- 작업 중 파일은 02_작업, 결과물은 03_산출에 저장한다
## 엑셀
- 엑셀의 합계·차이 같은 계산 칸은 **수식**으로 넣는다
메모장으로 열면 기호가 섞인 그냥 글자이고, 마크다운을 보여 주는 화면으로 열면 제목과 굵은 글씨, 목록으로 보입니다. AI는 같은 파일을 기호 그대로 읽고, 우리는 서식으로 읽습니다.
# 회계팀 작업 폴더 규칙
## 폴더
- 01_받은자료는 원본이다. 읽기만 하고 **고치지 않는다**
- 결과물은 03_산출에 저장한다
## 엑셀
- 합계·차이 같은 계산 칸은 **수식**으로 넣는다
- 01_받은자료는 원본이다. 읽기만 하고 고치지 않는다
- 결과물은 03_산출에 저장한다
- 합계·차이 같은 계산 칸은 수식으로 넣는다
외울 것은 # 제목, ** 강조, - 목록 세 가지뿐입니다. 표나 코드를 나타내는 기호도 몇 가지 더 있지만, 대부분은 클로드에게 "이 규칙을 마크다운으로 정리해 줘"라고 하면 써 줍니다. 우리는 지침 파일을 열어 읽고 고칠 수 있을 만큼만 눈에 익혀 두면 됩니다.
할루시네이션: 근거가 없는 자리에서 지어낸 답
할루시네이션(Hallucination, 환각)은 AI가 사실이 아닌 것을 사실처럼 그럴듯하게 지어내는 현상입니다. 예를 들어 AI에게 재고자산 평가손실 환입의 근거를 물으면, K-IFRS 제1002호에 없는 문단 34의2와 34의3을 자신 있게 인용하기도 합니다. 실제 기준서에서 환입 한도는 문단 33에, 환입액의 회계처리는 문단 34에 있습니다. 결산 마감에 쫓기며 이런 답을 그대로 결산 보고서나 감사 대응 자료에 옮겨 적는다면 없는 문단이 근거로 남게 됩니다.
AI에게 거짓말을 하려는 의도는 없습니다. 판단에 필요한 근거, 곧 컨텍스트가 없는 자리에서 사실을 확인하지 않은 채 가장 그럴듯한 다음 말을 확률로 고르다 보니 없는 문단이나 조항까지 만들어 내는 것입니다. 1장에서 본 확률 모델의 성질이 그대로 드러나는 장면입니다. 따라서 대책도 근거를 넘기고 결과를 검증하는 데 있습니다.
- 근거를 넘긴다: 기준서나 법령 원문을 컨텍스트로 넘기거나 MCP로 연결해, AI가 기억에서 꺼내지 않고 원문을 직접 조회하게 합니다.
- 출처를 요구한다: 숫자와 조문, 문단이 나오면 출처를 함께 적게 하고, 그 출처를 원문에서 다시 확인합니다.
- 계산은 코드로 한다: 숫자 계산은 AI에게 직접 시키지 않고 코드로 시켜, 계산에 확률이 끼어들 자리를 없앱니다.
이렇게 해도 AI가 내놓은 결과를 믿을 수 있는지는 마지막에 사람이 확인해야 합니다. 앞에서 본 것처럼 1위 모델도 정답률이 70%대라는 사실을 기억해 두면, 어디까지 맡기고 어디부터 확인할지가 자연스럽게 정해집니다.
두 한계를 클로드 코드로 채우는 길
여기까지 오면 한 가지 질문이 남습니다. 원래 개발자의 도구인 클로드 코드가 왜 코드를 모르는 회계·재무 실무자에게도 필요할까요? 답은 3장의 세 재료를 챗봇에서 쓸 때와 클로드 코드에서 쓸 때를 나란히 놓으면 드러납니다.
- 컨텍스트(사전학습의 한계): 챗봇에서는 필요한 파일을 골라 첨부하고 설명해야 하지만, 클로드 코드는 작업 폴더의 파일과 MCP·스킬을 스스로 찾아 읽습니다.
- 프롬프트(확률 모델의 한계): 챗봇에서는 맞춤형 지침이나 프로젝트 지침 칸에 적어 두지만, 클로드 코드는 작업 폴더의
CLAUDE.md와 업무별SKILL.md를 일할 때마다 읽습니다. - 코드(확률 모델의 한계): 챗봇에서는 코드가 대화 안에만 남아 다음 달에는 새로 짜야 하지만, 클로드 코드는 쓴 코드를 저장해 두고 다음에도 그대로 다시 돌립니다.
반복 업무에서는 마지막 줄이 특히 중요합니다. 클로드 코드는 저장해 둔 같은 코드를 다시 돌리므로 매달 같은 결과가 나옵니다. 서론에서 이야기한 '반복은 코드로, 판단은 AI에게'가 실제로 돌아가는 자리가 바로 여기입니다.
세 줄 모두 답은 개발자들이 원래 일하는 방식인 '내 PC에서, 코드로'입니다. 숫자가 정확해야 하고 매달 같은 방법이어야 하는 회계·재무 실무에 꼭 맞는 방식입니다. 그리고 코드는 클로드 코드가 짜고 돌리고 저장하므로, 우리는 말로 시키고 결과를 확인하면 됩니다.
1~4장의 열두 용어는 결국 AI 에이전트에게 남은 두 한계를 컨텍스트와 프롬프트, 코드로 채우는 이야기였고, 그 일을 내 PC에서 해 주는 도구가 클로드 코드입니다. 용어는 한 번 읽는 것보다 직접 써 볼 때 훨씬 빨리 익숙해집니다.
참고
- Vals AI, Excel Modeling 벤치마크: https://vals.ai/benchmarks/emb
- Vals AI, Tax Agent Bench: https://vals.ai/benchmarks/tax_agent_bench
- Artificial Analysis, 모델 리더보드: https://artificialanalysis.ai/leaderboards/models
- 앤트로픽, API 가격표(Pricing): https://platform.claude.com/docs/en/about-claude/pricing
- 앤트로픽, Vision 문서(이미지 토큰 계산): https://platform.claude.com/docs/en/build-with-claude/vision
- 앤트로픽 고객지원, Understanding usage and length limits: https://support.claude.com
비슷한 고민을 하고 계신가요? AI 강의·워크숍, 업무 자동화 — 편하게 문의 주세요.