1부. 문제와 원리
1.2. 반복은 결정론으로, 판단은 AI에게
업무를 반복과 판단으로 쪼개면 열에 아홉은 반복입니다. 무엇을 AI에게 맡기고 무엇을 맡기지 말아야 하는지, 결정론 90% + AI 10%라는 전략과 세 약점에 대한 대책의 원칙을 세웁니다.
앞 챕터에서 우리는 업무자동화가 실패하는 두 가지 한계를 확인했습니다. 결정론적 방식은 예외와 비표준 앞에서 멈췄고, AI는 불확정성 앞에서 흔들렸습니다.
이 실패를 겪고 나면 실무자들의 반응은 대개 두 가지로 갈립니다. 한쪽은 "역시 AI로 우리 일을 자동화하는 건 아직 무리야" 라며 단념하고, 다른 한쪽은 더 최신 모델, 더 비싼 요금제, 더 뛰어난 프롬프트 팁을 찾아 헤맵니다.
하지만 두 가지 모두 정답이 아닙니다. 이번 챕터에서는 두 실패의 원인을 분석하고, 그 해결책을 제시해보겠습니다.
1. 두 실패의 원인은 결국 하나였다
앞 챕터의 두 실패는 원인도 다르고 대책도 따로 세워야 할 것처럼 보입니다. 하지만 본질을 들여다보면 이유는 하나입니다. 도구의 특성과 그 도구가 쓰인 자리가 서로 엇갈려 있었기 때문입니다.
| 비교 항목 | 규칙 기반 방식 (매크로·스크립트) | 생성형 AI (LLM) |
|---|---|---|
| 동작 원리 | 결정론 (0과 1의 정해진 규칙) | 확률모델 (문맥 기반 토큰 예측) |
| 강점 | 만 번을 돌려도 똑같은 서식과 완벽한 수식 계산 | 비정형 문서 읽기, 맥락 파악, 예외 상황 해석 |
| 약점 | 규칙에 없는 예외나 비표준 양식을 만나면 즉시 중단 | 매번 결과가 달라져 서식을 깨뜨리거나 오차 발생 |
| 올바른 역할 | 틀과 서식을 고정하는 뼈대 | 맥락을 읽고 판단하는 두뇌 |
문제는 우리가 마주하는 실무가 이 두 가지 성격을 동시에 요구한다는 점입니다.
현장의 실무는 매번 제각각인 비정형 문서와 예외사항을 해석하는 유연한 판단이 필요하면서도, 최종 결과물만큼은 정해진 양식에서 벗어나지 않는 완벽한 일관성을 요구합니다. 한 가지 도구만 골라 업무 전체에 사용하는 순간 어느 한쪽의 약점이 반드시 터지게 되어 있습니다.
그리고 지금까지 우리가 AI를 써온 방식이 정확히 이 엇갈림이었습니다. 필요한 것은 몇 줄의 판단뿐이었는데, 서식과 수식과 계정 체계까지 포함된 파일 전체를 AI에게 통째로 넘기며 알아서 완성해 달라고 요청해 온 것입니다.
그 결과 AI는 엉뚱한 계정과목을 불러오거나 엑셀 수식을 깨뜨려 대차를 어긋나게 만들었습니다. PPT 보고서나 다른 문서에서도 마찬가지입니다. 회사의 표준 템플릿, 슬라이드 레이아웃, 지정 폰트 같은 고정된 형식까지 AI에게 맡겨버리면, AI는 매번 제각각인 디자인과 깨진 서식을 내놓습니다.
2. 내 업무를 쪼개보면: 90%의 반복과 10%의 판단
배치를 바로잡으려면 가장 먼저 내 업무를 성격별로 분해해 보아야 합니다. 과연 내 일에서 어디까지가 기계적인 반복이고, 어디부터가 고유한 판단일까요?
분기마다 재무제표 작성을 위해 만드는 결산파일(정산표) 를 예로 들어보겠습니다.
2.1. 90%의 반복 영역
- 문서의 서식과 계정 체계: 수정전 시산표(TB), 결산 수정분개, 재무상태표(BS), 손익계산서(PL)로 이어지는 표준 정산표 서식과 계정과목(자산-부채-자본-수익-비용) 정렬 순서.
- 집계 및 대차 수식: 각 열의 합계를 구하는
SUM수식, 수정분개 반영식, 당기순손익 산출 및 대차평형을 맞추는 계산식. - 검증 로직: 전기말 잔액이 당기초로 정확히 이월되었는지 대사하고, 차변과 대변의 합계 차액이 정확히 0원인지 확인하는 검증.
이 90%의 영역은 지난 분기에도 똑같았고, 이번 분기에도 똑같으며, 1년 뒤에도 똑같아야 합니다. 규칙이 명확하고 단 1원의 오차도 허용되지 않는 결정론의 영역입니다.
2.2. 10%의 판단 영역
- 이번 분기에 새로 체결된 복잡한 계약서(리스 계약, 용역 계약 등) 원문을 읽고 회계적 쟁점을 파악하는 일.
- 거래처의 연체 현황이나 회수 가능성 관련 문서를 검토하여 대손충당금 설정 대상을 선별하는 일.
- 회계기준서와 사내 관례에 비추어 해당 거래를 어떤 '수정분개'로 반영할지 검토하는 일.
이것만이 매 분기 새롭게 해석하고 판단해야 하는 10%의 영역입니다.
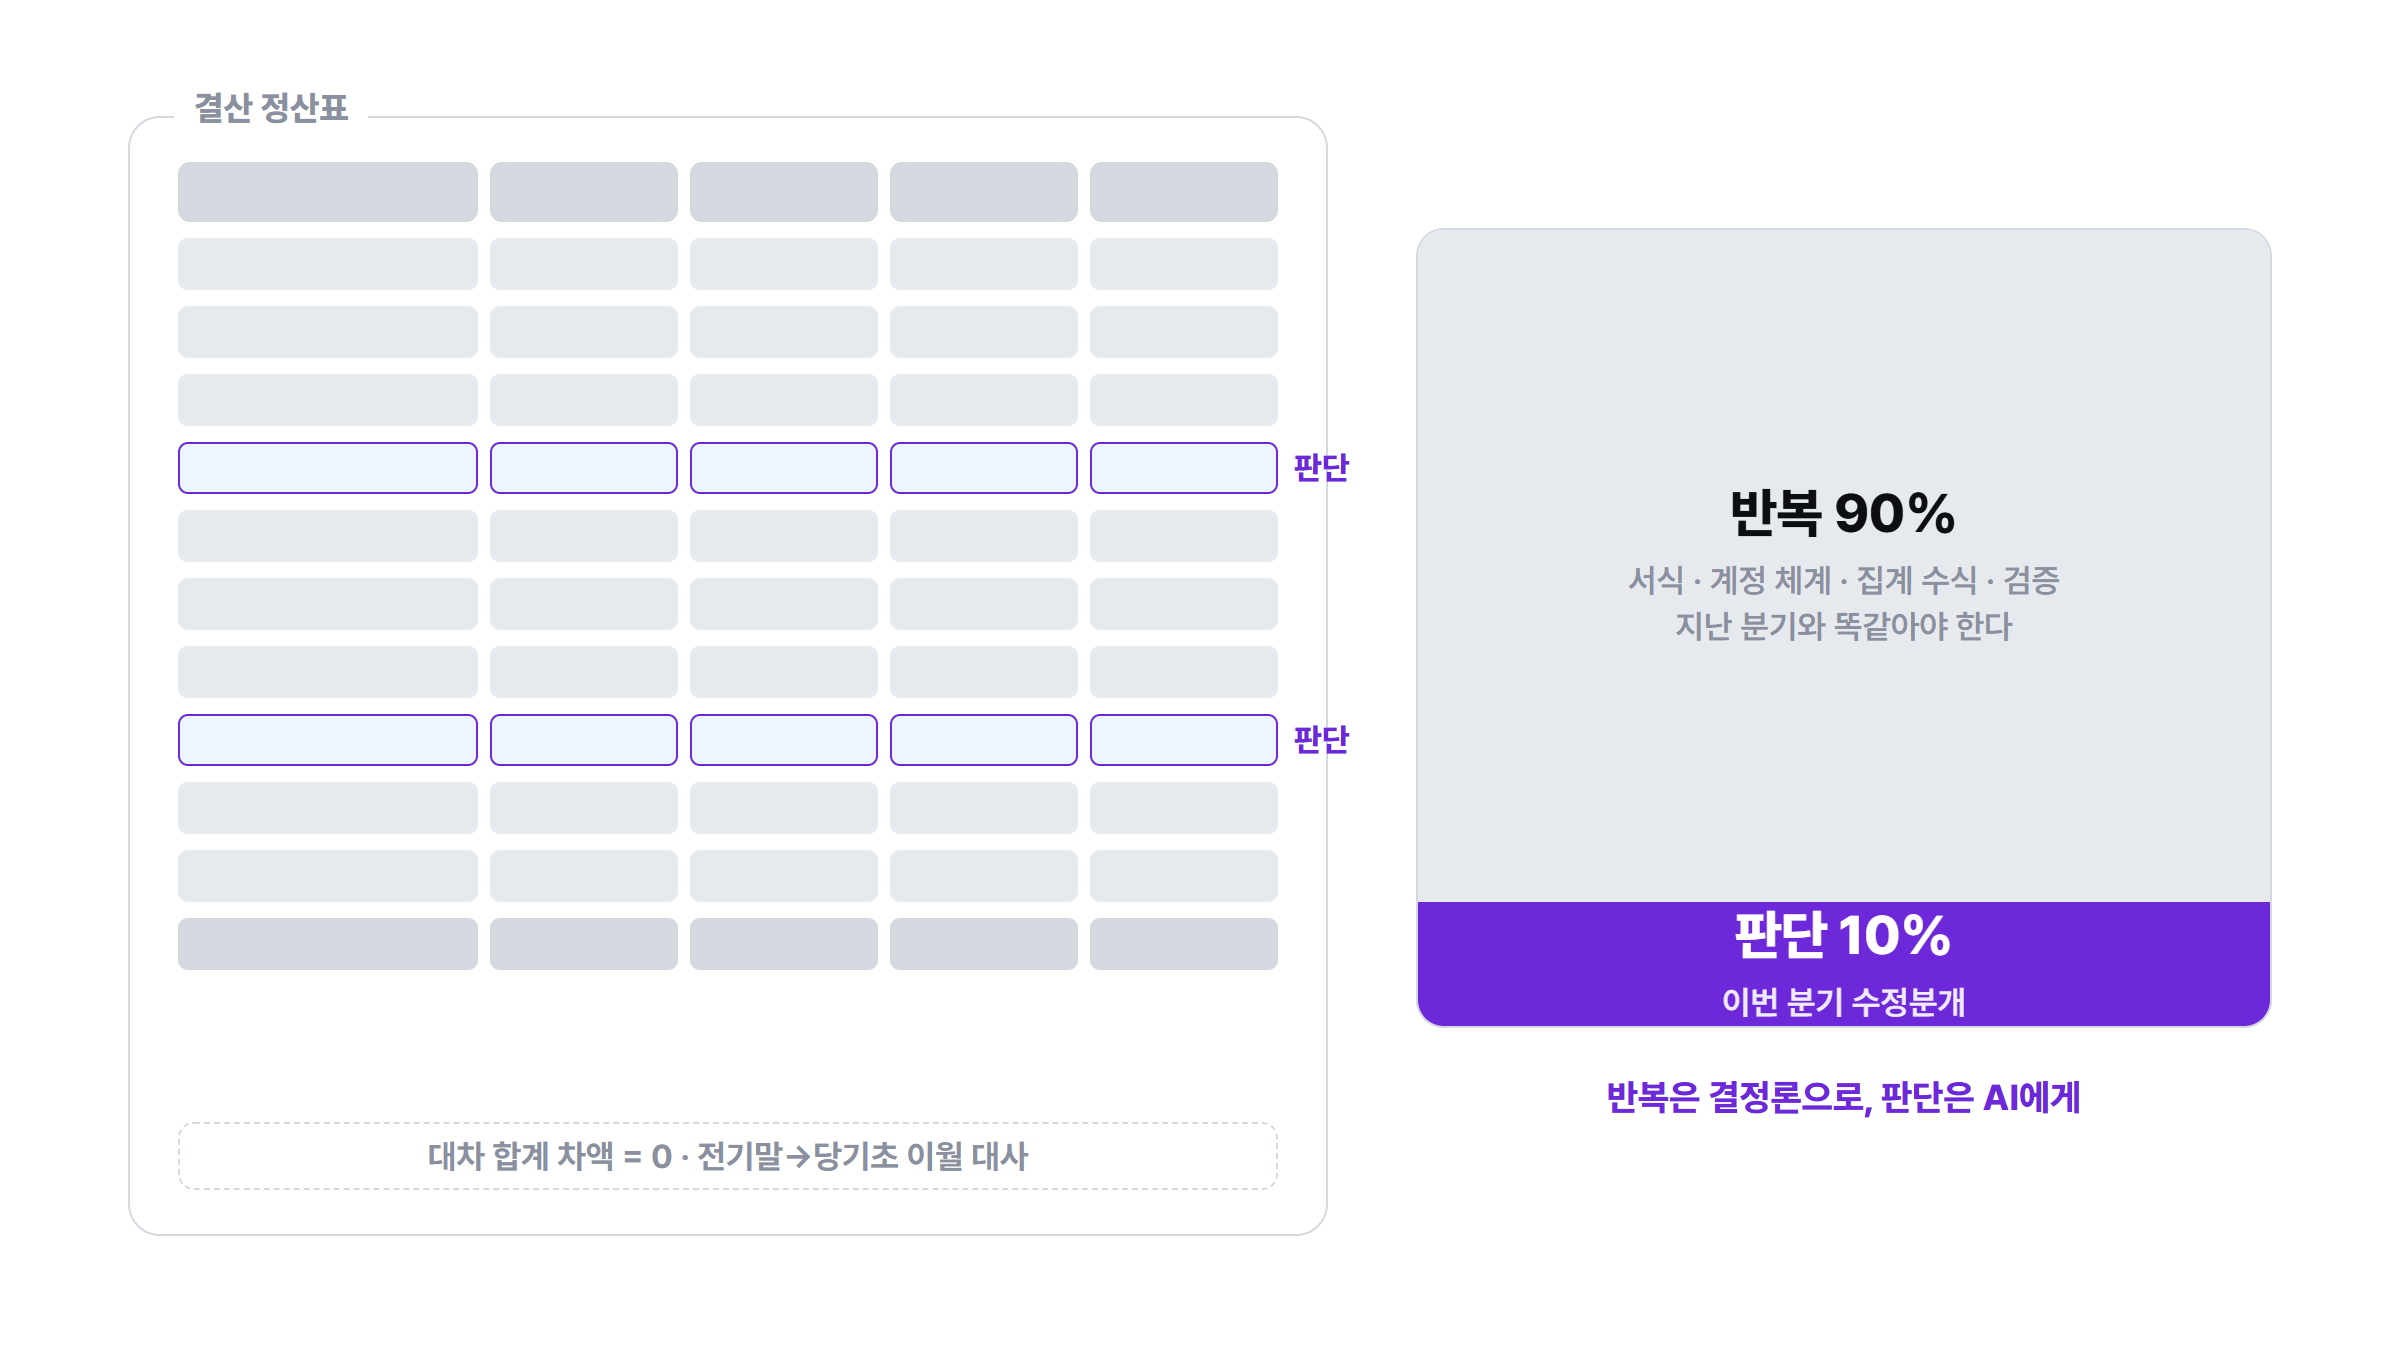 정산표 한 장을 갈라 보면 서식·계정 체계·집계 수식·검증은 지난 분기와 똑같아야 하는 반복이고, 이번 분기 수정분개 몇 줄만이 판단이다
3. 반복은 결정론으로, 판단은 AI에게
업무를 이렇게 쪼개고 나면, 해법은 명확해집니다.
반복은 결정론으로, 판단은 AI에게
90%의 반복은 코드로 고정하고, 매번 달라지는 10%의 판단에만 AI를 배치하는 것입니다.
 AI에게 통째로 맡기면 전체가 흔들리지만, 코드로 골격을 고정하면 AI의 불확정성은 판단의 범위로 한정됩니다.
이렇게 역할을 분리했을 때 얻는 가장 큰 이점은 일관성입니다. 서식, 계정과목 순서, 집계 수식 같은 기본 뼈대를 코드로 고정해 두면 몇 번을 실행하든 정해진 양식과 수식은 그대로 유지됩니다.
틀이 고정되면 실무자의 검토 부담도 크게 줄어듭니다.
- 전체를 AI에게 맡겼을 때: AI가 수식을 건드리거나 표를 망가뜨리지는 않았는지 매번 100줄 전체를 전수 검토해야 합니다.
- 역할을 분리했을 때: 90줄의 기본 서식과 계산은 코드가 보장하므로, 실무자는 AI가 채워 넣은 핵심 판단만 확인하면 됩니다.
4. 첫 질문을 바꾸면 진짜 자동화가 시작된다
혹자는 이렇게 생각할지 모릅니다.
앞으로 AI 모델이 훨씬 더 똑똑해지면, 이런 구분 없이 AI가 100% 다 알아서 해주지 않을까?
하지만 이는 착각입니다. 모델이 아무리 발전하더라도 실무자가 이 구조를 잡아야 하는 이유는 분명합니다.
- 확률모델의 본질은 변하지 않습니다: 모델의 지능이 아무리 높아져도 AI는 여전히 확률로 글을 생성합니다. 100번 중 99번 완벽해도 단 1번 오차가 생기면 결국 실무자가 전수 검토를 해야 하므로, 코드로 틀을 단단히 묶어두지 않은 AI는 실무에서 쓰일 수 없습니다.
- 우리 회사만의 고유한 규칙은 AI가 알지 못합니다: 모델이 아무리 똑똑해져도 우리 회사의 정산표 양식, 특정 계정과목 순서, 사내 검증 규칙을 스스로 알아맞힐 수는 없습니다. "무엇이 매번 똑같아야 하는가"를 실무자가 명확한 뼈대(코드)로 박아두지 않는 한, AI는 매번 제각각인 서식을 만들어낼 뿐입니다.
결국 실무 자동화의 성패는 더 똑똑한 최신 모델을 기다리는 것이 아니라, 우리가 AI를 켤 때 던지는 첫 질문에 달려 있습니다.
❌ 기존의 질문
"이 업무를 AI에게 어떻게 시키지?"
✅ 앞으로 던져야 할 질문
"이 업무에서 무조건 똑같아야 하는 반복(코드)은 무엇이고, 매번 달라지는 판단(AI)은 어디까지인가?"
이 질문에 답하여 반복을 코드로 단단히 잠그고 남은 판단에만 AI를 배치하는 순간, 모델의 발전 여부와 상관없이 당장 오늘부터 흔들리지 않는 진짜 실무 자동화가 시작됩니다.
그렇다면 여기서 결정적인 의문이 하나 남습니다.
그 90%의 결정론(코드)을 어떻게 만드나요? 프롬프트에 '이 양식 꼭 지켜'라고 쓰면 안 되나요?
다음 챕터에서는 왜 아무리 정교한 프롬프트로도 결정론을 만들 수 없는지, 그리고 컴퓨터가 실행할 때 토큰 요금이 0원이 되는 '코드와 토큰의 비밀' 을 살펴보겠습니다.
이 가이드 그대로 팀·조직 교육이 필요하신가요? 실무자 눈높이의 강의·워크숍으로 진행합니다.