가이드 › 1장. AI 핵심 용어
생성형 AI, LLM, 모델
생성형 AI와 LLM이 무엇이고, AI가 글만 쓰면서도 엑셀 파일을 만드는 원리, 모델과 추론 수준을 고르는 기준을 정리합니다.
이 장에서 할 일
AI, 생성형 AI, LLM이 어떻게 다른지 구분합니다. 글만 쓰는 AI가 어떻게 엑셀 파일을 만드는지 이해하고, 모델과 추론 수준을 고르는 기준을 잡습니다.
1. 용어부터 익숙해져야 하는 이유
저는 AI를 업무에 활용할 때 가장 먼저 할 일이 용어에 익숙해지는 것이라고 생각합니다.
처음 세법을 공부할 때 '부당행위계산의 부인' 같은 말 앞에서 한참을 멈춰 있었는데, 생전 처음 듣는 말이라 뜻을 몇 번 읽어도 개념이 도무지 와닿지 않았습니다. 하지만 그 말을 여러 번 보고 입에 붙고 나니, 그제야 내용이 머리에 들어오기 시작했습니다.
AI도 마찬가지로 토큰, 컨텍스트, MCP 같은 말이 낯선 동안에는 설명이 겉돌지만, 말이 익숙해지면 뉴스와 도구 설명서가 읽히기 시작합니다. 저는 용어에 익숙해지는 것만으로 AI 활용 역량의 절반 가까이를 갖추게 된다고 봅니다. 여러 사람이 AI를 업무에 붙이는 과정을 옆에서 도와 보면, 도구가 손에 익지 않아서 못 쓰는 경우보다 용어가 익숙하지 않아서 못 쓰는 경우가 훨씬 많았기 때문입니다.
따라서 1부에서는 AI를 쓰는 데 필요한 핵심 개념 아홉 가지를 세 단계로 나눠 익힙니다.
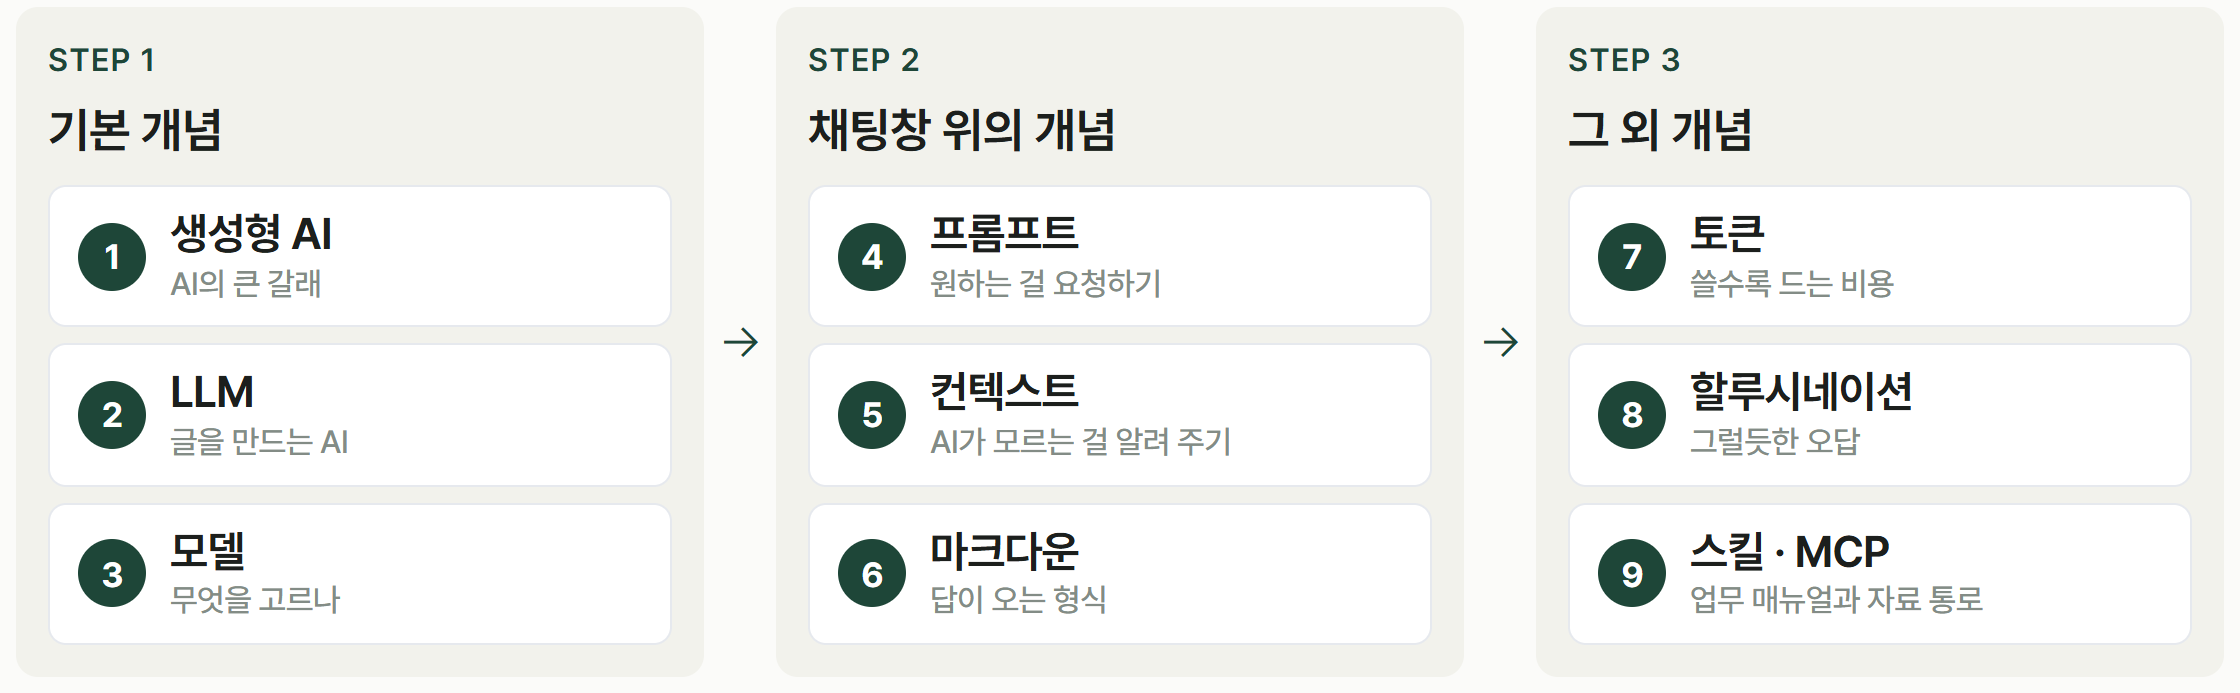 1부에서 익힐 핵심 개념 아홉 가지
순서는 챗봇을 처음 쓸 때 거치는 흐름을 그대로 따랐습니다.
- 켜기 전(1~3): 이것이 무엇이고 무엇을 골라야 하는지
- 대화할 때(4~6): 무엇을 쓰고 무엇을 알려 주며, 답이 어떤 형식으로 오는지
- 쓰다 보면(7~9): 부딪히는 비용과 틀린 답, 그리고 그 해결책
1.1장에서 13을, 1.2장에서 46을, 1.3장에서 토큰과 할루시네이션을, 1.4장에서 스킬과 MCP를 차례로 다룹니다.
처음 듣는 말이 대부분이라면 한 번 읽고 다 이해되지 않는 것이 당연하고, 앞의 용어를 설명하다 보면 뒤의 용어가 먼저 튀어나오기도 합니다. 1부를 한 번 쭉 읽은 뒤 그림 위주로 다시 훑어보면 그때는 내용이 훨씬 잘 들어옵니다.
2. AI, 생성형 AI, LLM
우리가 AI라는 말을 처음 실감한 것은 아마 구글이 만든 바둑용 AI, 이세돌 9단과 바둑을 둔 알파고였을 겁니다. 이처럼 AI는 원래 사람처럼 판단하고 예측하는 프로그램 전체를 가리키며, 메일함에서 스팸을 알아서 걸러 내는 필터나 유튜브의 추천 알고리즘도 모두 AI의 영역입니다. 다만 이런 AI는 정해진 것 가운데서 고르거나 분류하는 데 그치고, 알파고 역시 둘 수 있는 수 가운데 다음 수를 골랐을 뿐 새로운 것을 만들지는 않았습니다.
하지만 챗GPT(ChatGPT)가 등장한 뒤로는 '생성형 AI'라는 말을 자주 듣게 되었습니다. 생성형 AI는 학습한 데이터를 바탕으로 세상에 없던 새 결과물, 곧 글·그림·영상·음성을 만들어 내는 AI입니다. 쉽게 말해 알파고가 고르는 AI라면 생성형 AI는 만드는 AI이며, 요즘 우리가 그냥 'AI'라고 부르는 것은 대부분 이쪽입니다.
LLM은 그중에서도 글(텍스트)에 초점을 맞춘 생성형 AI입니다. 챗GPT, 클로드(Claude), 제미나이(Gemini)의 대화 기능이 여기에 속하고, 이 시리즈에서 쓰는 클로드 엑셀도 LLM입니다.
세 말의 관계를 그림으로 나타내면 다음과 같은 동심원이 됩니다.
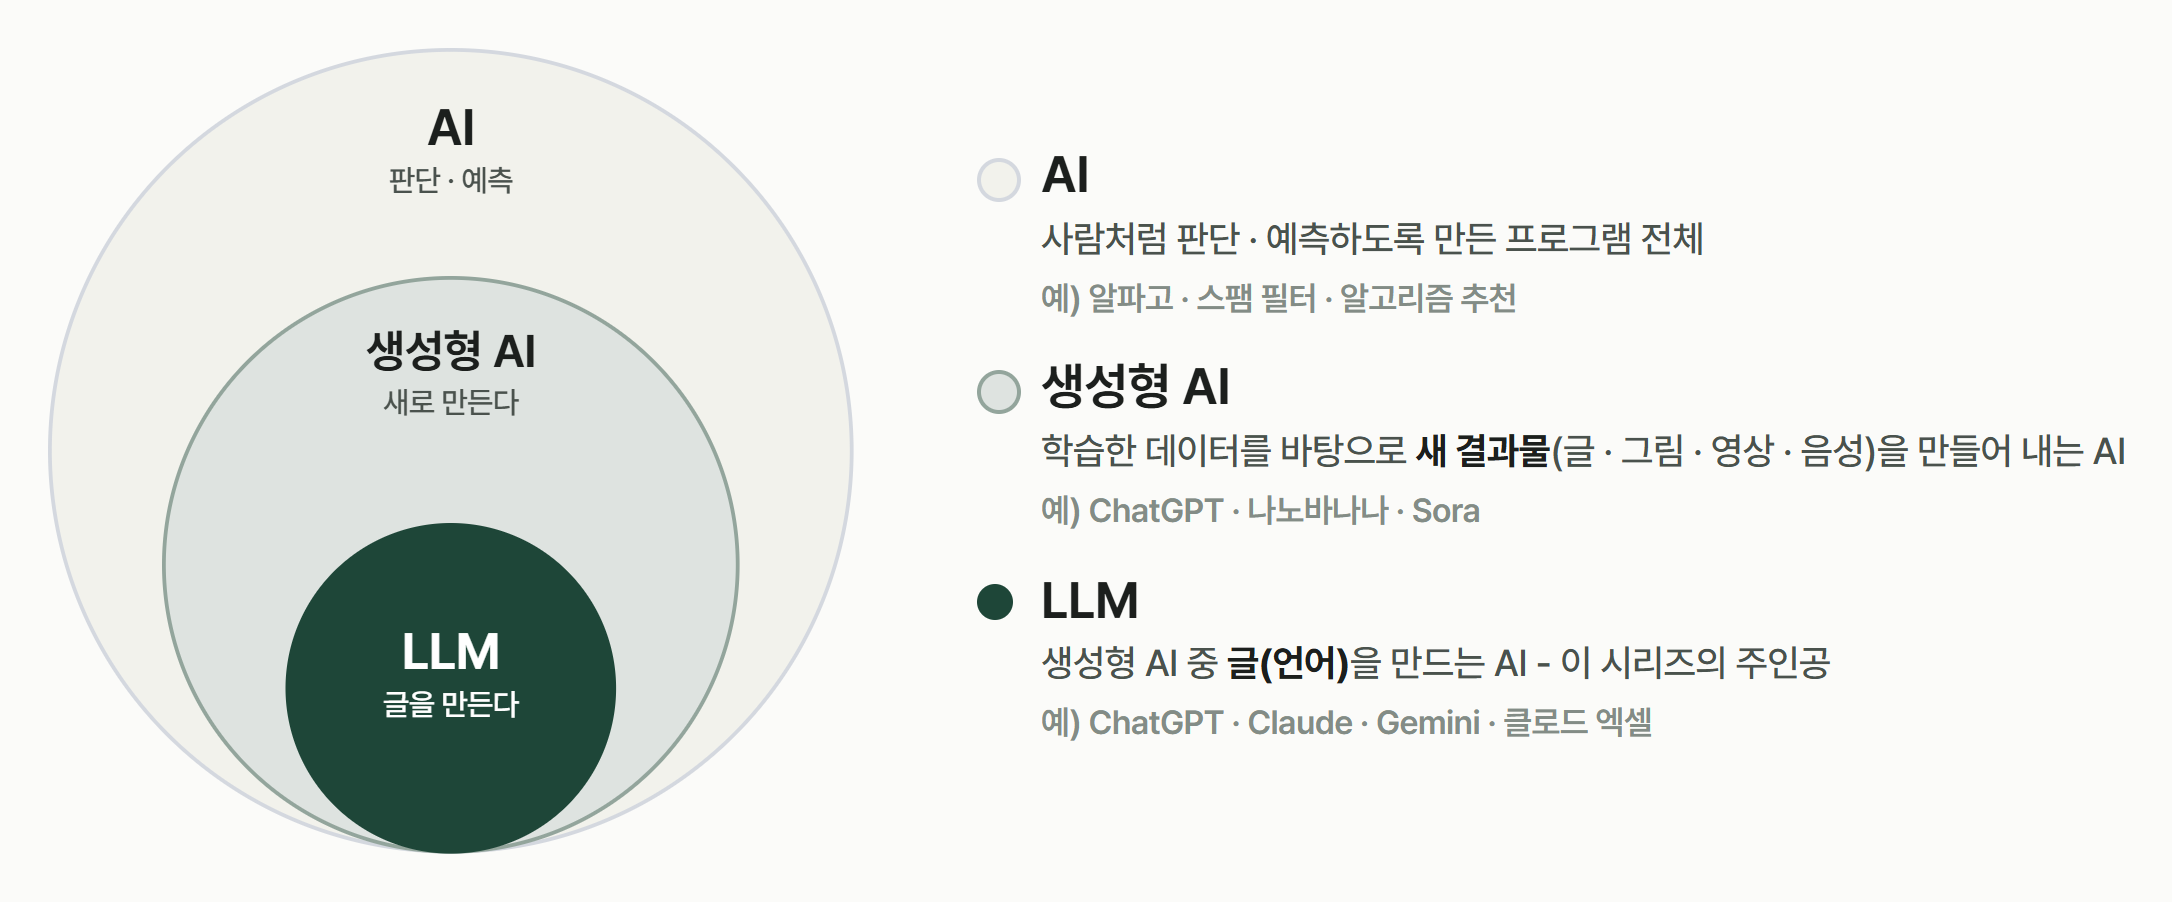 AI ⊃ 생성형 AI ⊃ LLM
가장 바깥 원이 판단하고 예측하는 AI 전체, 그 안이 새로 만드는 생성형 AI, 가장 안쪽이 글을 만드는 LLM입니다. 안쪽 원은 바깥 원에 속하지만 그 반대는 성립하지 않아서, 알파고는 AI지만 생성형 AI는 아니고 그림을 그리는 나노바나나는 생성형 AI지만 LLM은 아닙니다.
생성형 AI를 한 겹 더 펼쳐 보면, 무엇을 만드느냐에 따라 다시 나뉩니다.
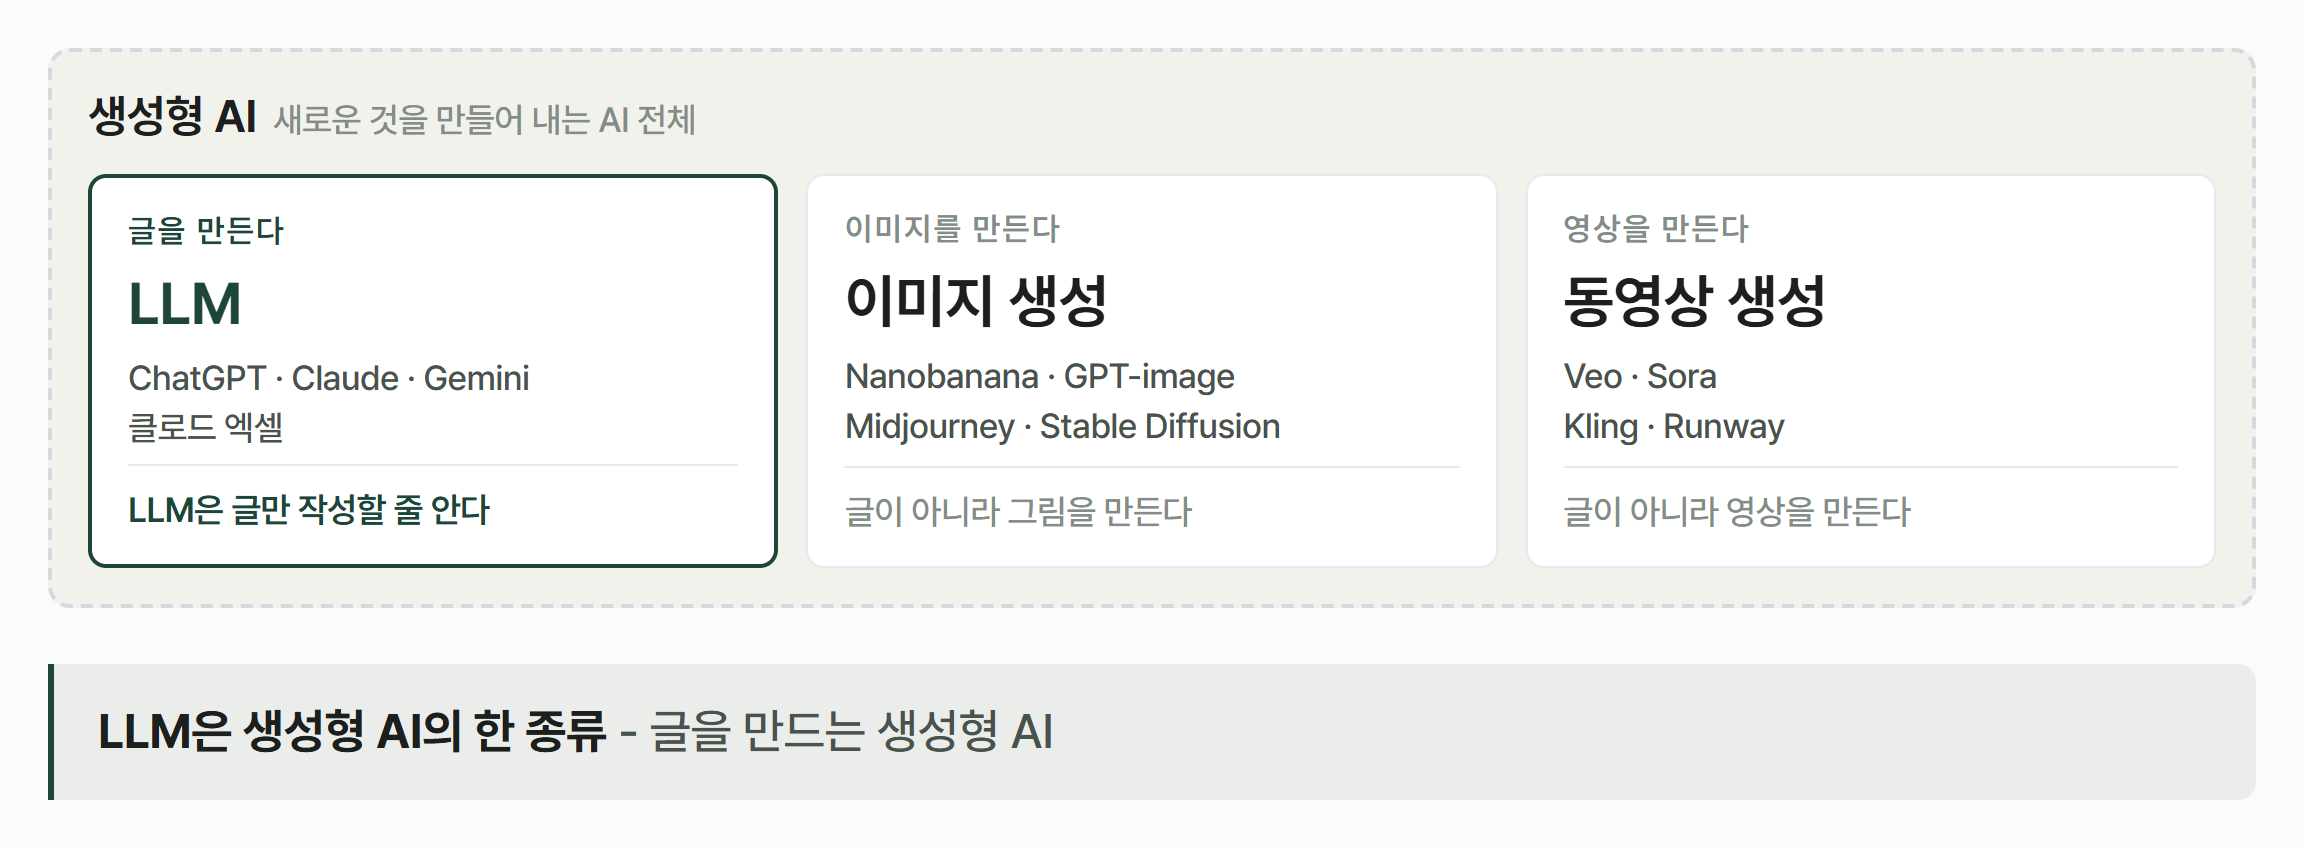 생성형 AI는 무엇을 만드느냐로 나뉜다
- 글: LLM
- 그림(이미지 생성 모델): 나노바나나, GPT-image, 미드저니, 스테이블 디퓨전
- 영상(동영상 생성 모델): Veo, 소라(Sora), Kling, Runway
요즘 이미지 모델 중에는 LLM 계열 모델을 바탕으로 만든 것도 있어 경계가 조금씩 흐려지고 있지만, 무엇을 만드느냐(글·그림·영상)로 구분하면 됩니다. 이 시리즈의 주인공은 그림의 첫 칸에 있는, 글을 읽고 글을 쓰는 LLM입니다.
3. LLM이라는 이름
AI를 쓰는 데 필요한 원리는 LLM(대규모 언어 모델, Large Language Model) 이라는 이름 세 단어에 거의 다 들어 있습니다. 뉴스에서 자주 듣는 말이지만 뜻을 하나씩 따져 볼 기회는 많지 않으니, 세 단어를 차례로 풀어 보겠습니다.
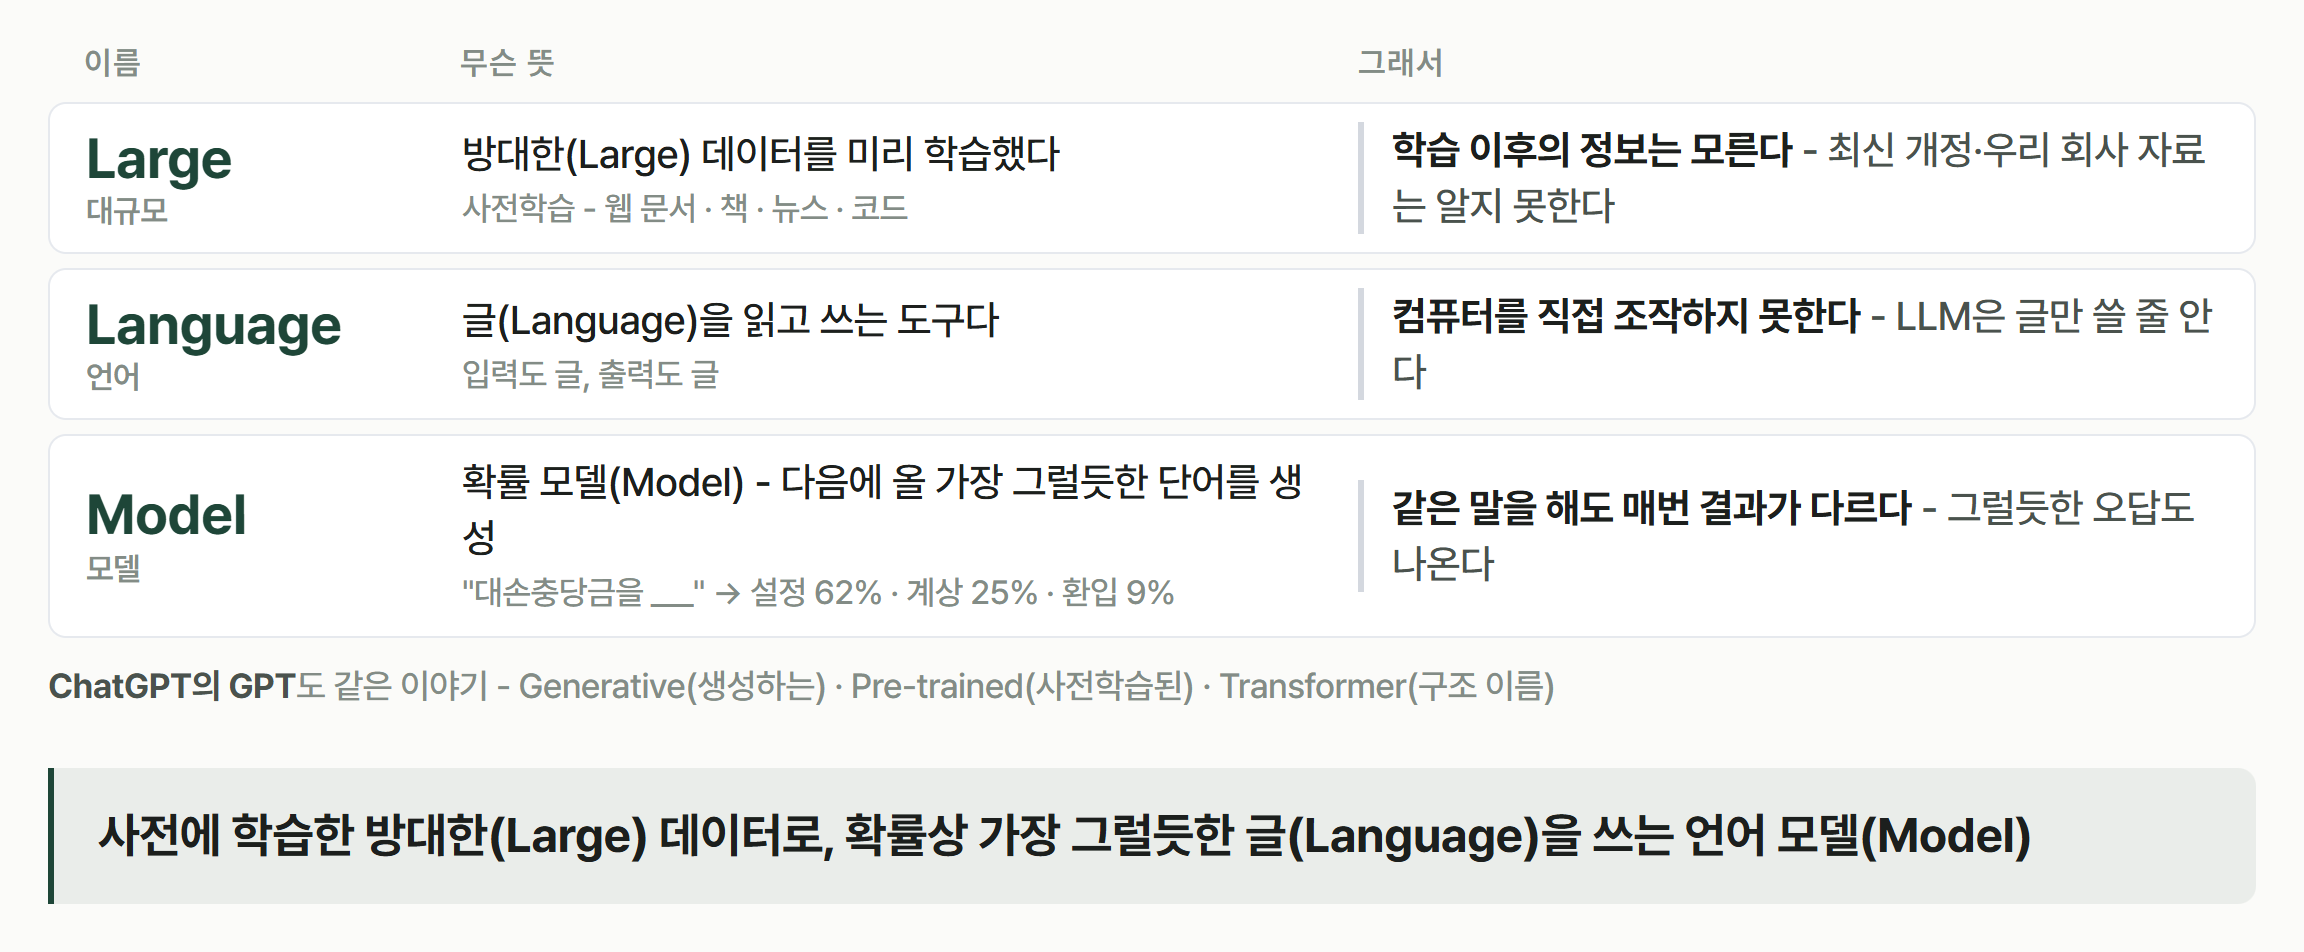 LLM이라는 이름에 담긴 세 가지 뜻
그림은 한 줄씩 왼쪽에서 오른쪽으로 읽으며, 각 줄에는 이름과 그 뜻, 그리고 그 때문에 실무에서 무엇이 달라지는지를 적었습니다.
Large(대규모)는 방대한 데이터를 미리 학습했다는 뜻으로, 웹 문서와 책, 뉴스, 코드를 대량으로 읽혀 두는 이 과정을 '사전학습'이라고 합니다. 따라서 LLM은 학습이 끝난 뒤의 정보를 모르며, 올해 개정된 세법이나 우리 회사의 계정과목표도 알지 못합니다. 이 빈자리를 어떻게 채우는지는 1.2장의 컨텍스트에서 다룹니다.
Language(언어)는 글을 읽고 쓰는 도구라는 뜻으로, 입력도 글이고 출력도 글입니다. 즉 LLM은 글만 쓸 줄 알고, 마우스를 움직이거나 파일을 저장하는 식으로 컴퓨터를 직접 조작하지는 못합니다.
Model(모델)은 확률 모델이라는 뜻입니다. LLM은 문장을 한 번에 쓰지 않고, 앞의 말을 읽은 뒤 다음에 올 가장 그럴듯한 말을 확률로 골라 이어 붙입니다. 예를 들어 "대손충당금을 ___"까지 읽었다면 '설정' 62%, '계상' 25%, '환입' 9% 같은 확률표에서 하나를 뽑는 식이며, 이 일을 수천 번 되풀이한 결과가 우리가 받는 답입니다.
다만 LLM은 이 확률표에서 매번 1등만 고르지는 않습니다. 이 때문에 프롬프트를 아무리 정교하게 써도 같은 말에 대한 답이 매번 조금씩 다르고, 가끔은 그럴듯한 오답도 나옵니다. 이런 차이는 결함으로 볼 일이 아니며, LLM이 동작하는 방식 그 자체에서 나옵니다(오답은 1.3장, 결과가 달라지는 성질은 7.1장).
챗GPT의 GPT도 같은 이야기로, Generative(생성하는), Pre-trained(사전학습된), Transformer(모델 구조의 이름)의 머리글자입니다. LLM의 세 단어를 한 문장으로 묶으면 그림 맨 아래 줄이 되며, 사전에 학습한 방대한(Large) 데이터로 확률상 가장 그럴듯한 글(Language)을 쓰는 언어 모델(Model)이라는 뜻입니다.
4. AI는 어떻게 엑셀 파일을 만드나
앞에서 LLM은 글만 쓴다고 했지만, 클로드에게 "이 표를 엑셀로 만들어 줘"라고 하면 몇 초 뒤 깔끔한 xlsx 파일이 나옵니다. 얼핏 보면 AI가 직접 엑셀을 띄워 셀에 값을 채워 넣은 것 같지만, 실제로는 다음 세 단계를 거쳐 파일이 만들어집니다.
- AI가 코드를 씁니다. "새 시트를 만들고, B2에 1월, C2에 이 수식을 넣어라"라는 지시를 파이썬 같은 프로그래밍 언어로 옮겨 적습니다. 코드도 결국 글이므로 LLM이 쓸 수 있습니다.
- 컴퓨터가 그 코드를 실행합니다. 클로드 앱이라면 서버 뒤편의 격리된 실행 환경이 코드를 한 줄씩 그대로 실행합니다.
- 실행된 코드가 파일을 만듭니다.
openpyxl같은 파이썬 라이브러리가 실제로 셀에 값을 넣고 서식을 입혀xlsx파일로 저장합니다. 우리가 내려받는 파일은 이 결과물입니다.
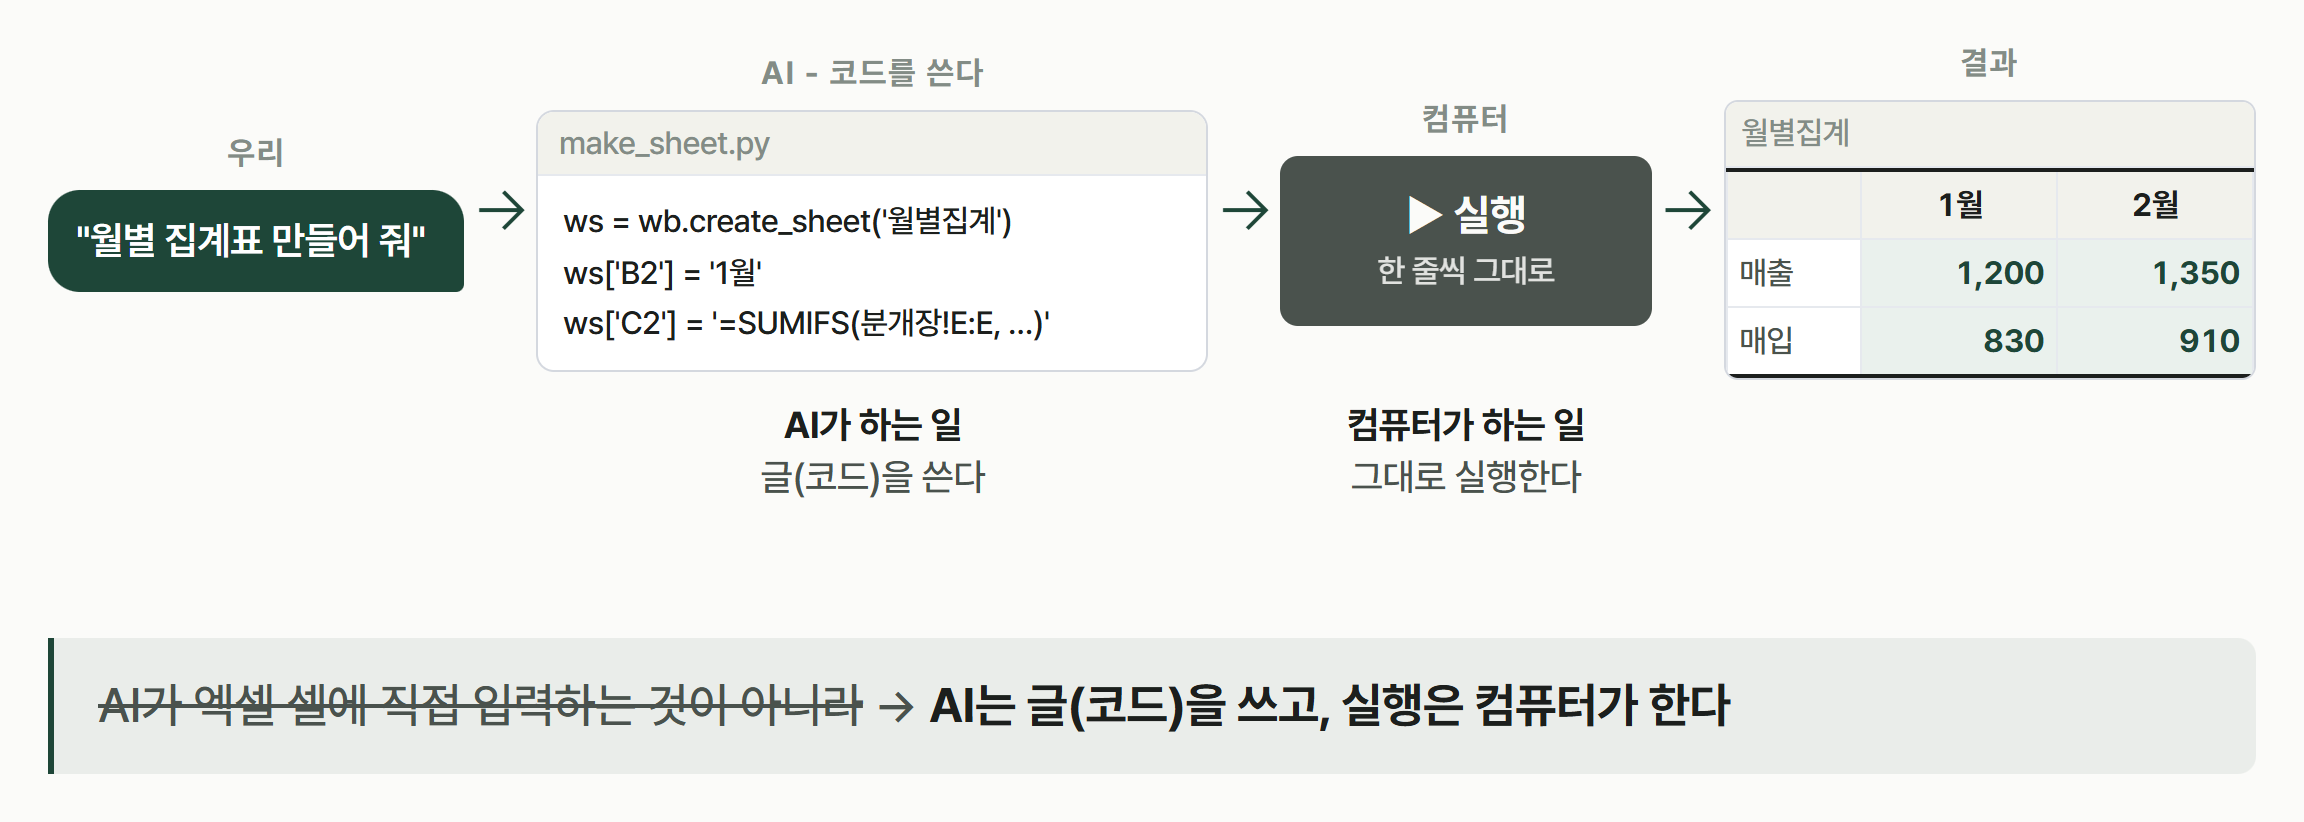 AI는 코드를 쓰고, 실행은 컴퓨터가 한다
그림을 왼쪽부터 보면, 우리가 "월별 집계표 만들어 줘"라고 할 때 AI는 make_sheet.py라는 코드에 '월별집계 시트를 만들고, B2에 1월, C2에 SUMIFS 수식을 넣어라'를 적습니다. 컴퓨터는 이 코드를 한 줄씩 그대로 실행하고, 그 결과로 오른쪽의 월별집계 시트가 생깁니다. 그림 아래의 두 칸은 역할 분담을 나타내며, AI가 하는 일은 글(코드)을 쓰는 데까지이고 실행은 컴퓨터가 맡습니다.
즉, 실제로 파일을 만드는 주체는 코드이며, AI는 그 코드를 글로 씁니다. 워드나 PPT 파일이 만들어지는 원리도 같습니다.
요리에 비유하면 AI는 레시피를 적는 요리사, 코드는 레시피, 컴퓨터는 레시피대로 요리하는 주방입니다. 요리사는 레시피를 새로 쓸 줄 알지만 매번 조금씩 다르게 쓰고, 주방은 받은 레시피를 오차 없이 따르지만 스스로 바꾸지는 못합니다. 둘이 잘하는 일이 다르다는 점은 7.1장에서 다시 다룹니다.
클로드에게 엑셀 파일을 요청한 뒤 진행 메시지를 펼쳐 보면 AI가 쓴 코드를 그대로 확인할 수 있습니다. 클로드 엑셀도 같은 방식으로 일하며, 그 모습은 4.4장에서 살펴보겠습니다.
이렇게 코드를 쓰는 AI, 곧 채팅창 너머에서 우리 말을 받는 쪽이 다음 절에서 다룰 모델입니다. 같은 클로드 앱이라도 어떤 두뇌가 답하느냐에 따라 결과가 달라집니다.
5. 모델, AI의 두뇌
클로드 앱의 입력창 근처에는 Opus, Sonnet 같은 이름을 고르는 목록이 있는데, 처음에는 무엇인지 몰라 기본값 그대로 두기 쉬운 이 목록이 바로 모델입니다.
모델은 질문을 받아 답을 만드는 두뇌입니다. 쉽게 말해 우리가 접속하는 클로드, 챗GPT, 제미나이는 서비스(앱)의 이름이고, 그 뒤에서 실제로 생각하고 답을 쓰는 것이 모델입니다. 모델은 만든 회사와 세대가 다르고, 한 회사 안에서도 등급이 나뉩니다.
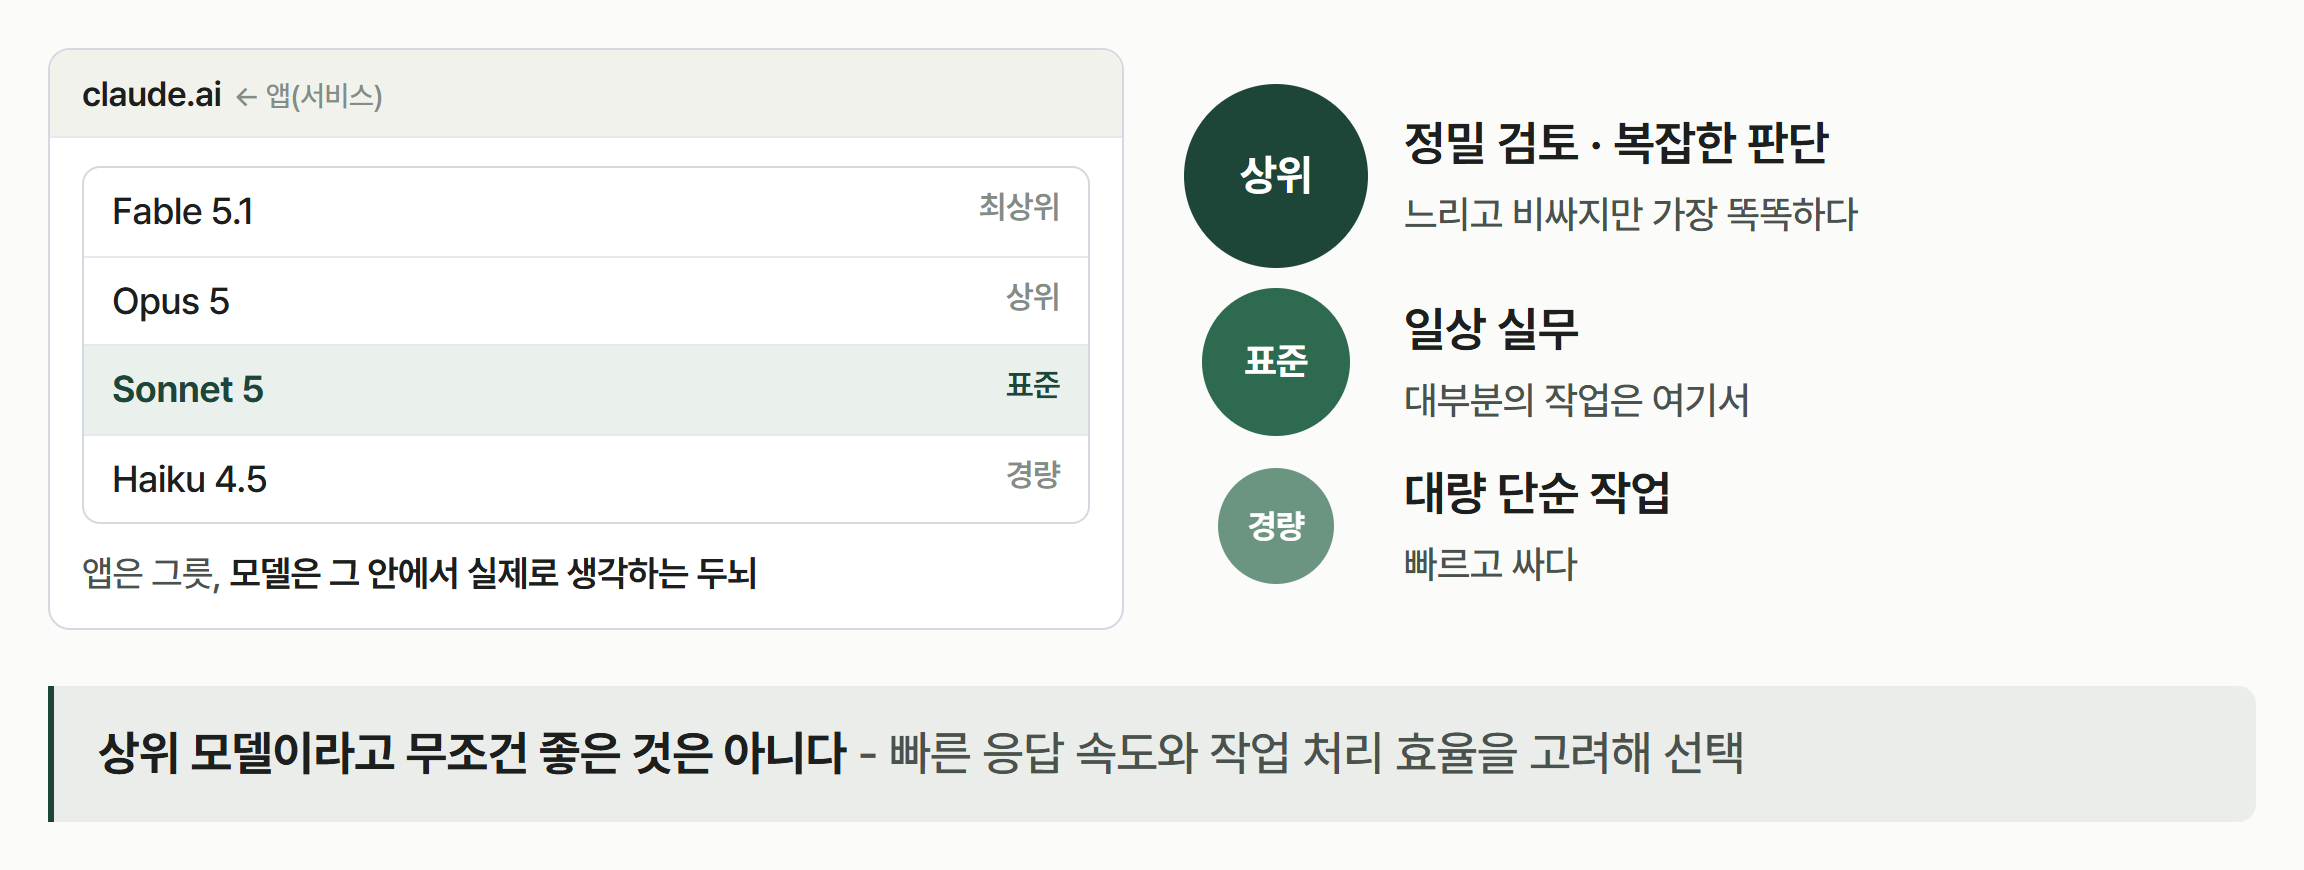 앱은 그릇, 모델은 그 안에서 생각하는 두뇌
그림 왼쪽은 claude.ai라는 앱(그릇) 안에서 고를 수 있는 모델 목록이고, 오른쪽은 등급마다 어울리는 일입니다(2026년 9월 기준, 모델 이름은 수시로 바뀝니다).
- Fable 5.1(최상위): 가장 어렵고 무거운 판단에 씁니다.
- Opus 5(상위): 정밀 검토와 복잡한 판단에 어울리며, 느리고 비싸지만 똑똑합니다.
- Sonnet 5(표준): 일상 실무 대부분은 여기서 합니다.
- Haiku 4.5(경량): 대량의 단순 작업을 빠르고 싸게 처리합니다.
정밀한 판단에는 상위 모델을, 대량의 단순 작업에는 경량 모델을 씁니다. 예를 들어 리스 계약서 몇 건을 읽고 기준서상 리스에 해당하는지 따지는 일은 상위 모델에 맡기고, 수백 줄의 적요에서 거래처명만 뽑아 정리하는 일은 경량 모델로도 충분할 뿐 아니라 오히려 더 빠릅니다.
다만 상위 모델이 무조건 좋은 것은 아니어서, 상위 모델일수록 같은 구독 한도 안에서 쓸 수 있는 양이 줄어듭니다. 제 경험으로는 우리 실무의 대부분은 최상위 모델까지 필요하지 않고 표준 모델로 충분합니다. 특히 최상위 모델은 깊게 생각하느라 답이 늦지만 표준 모델은 곧바로 답하므로, 일의 흐름이 끊기지 않는다는 점도 큽니다. 모델은 이렇게 응답 속도와 작업 분량을 함께 보고 고르면 되며, 클로드 엑셀 뒤에도 같은 모델들이 있어서 그 안에서도 모델을 골라 쓸 수 있습니다.
6. 추론(노력) 수준
추론(노력) 수준은 AI가 답하기 전에 얼마나 생각하게 할지를 고르는 설정입니다. 모델을 고른 뒤에 하나 더 고를 수 있는 항목으로, 요즘 앱에는 '생각 모드', '추론 강도' 같은 이름으로 들어 있습니다. 이 수준을 높여 두면 답이 나오기 전에 '생각 중…'이라는 표시가 한참 떠 있는데, AI가 답하기 전에 스스로 따져 보는 과정을 거치기 때문입니다.
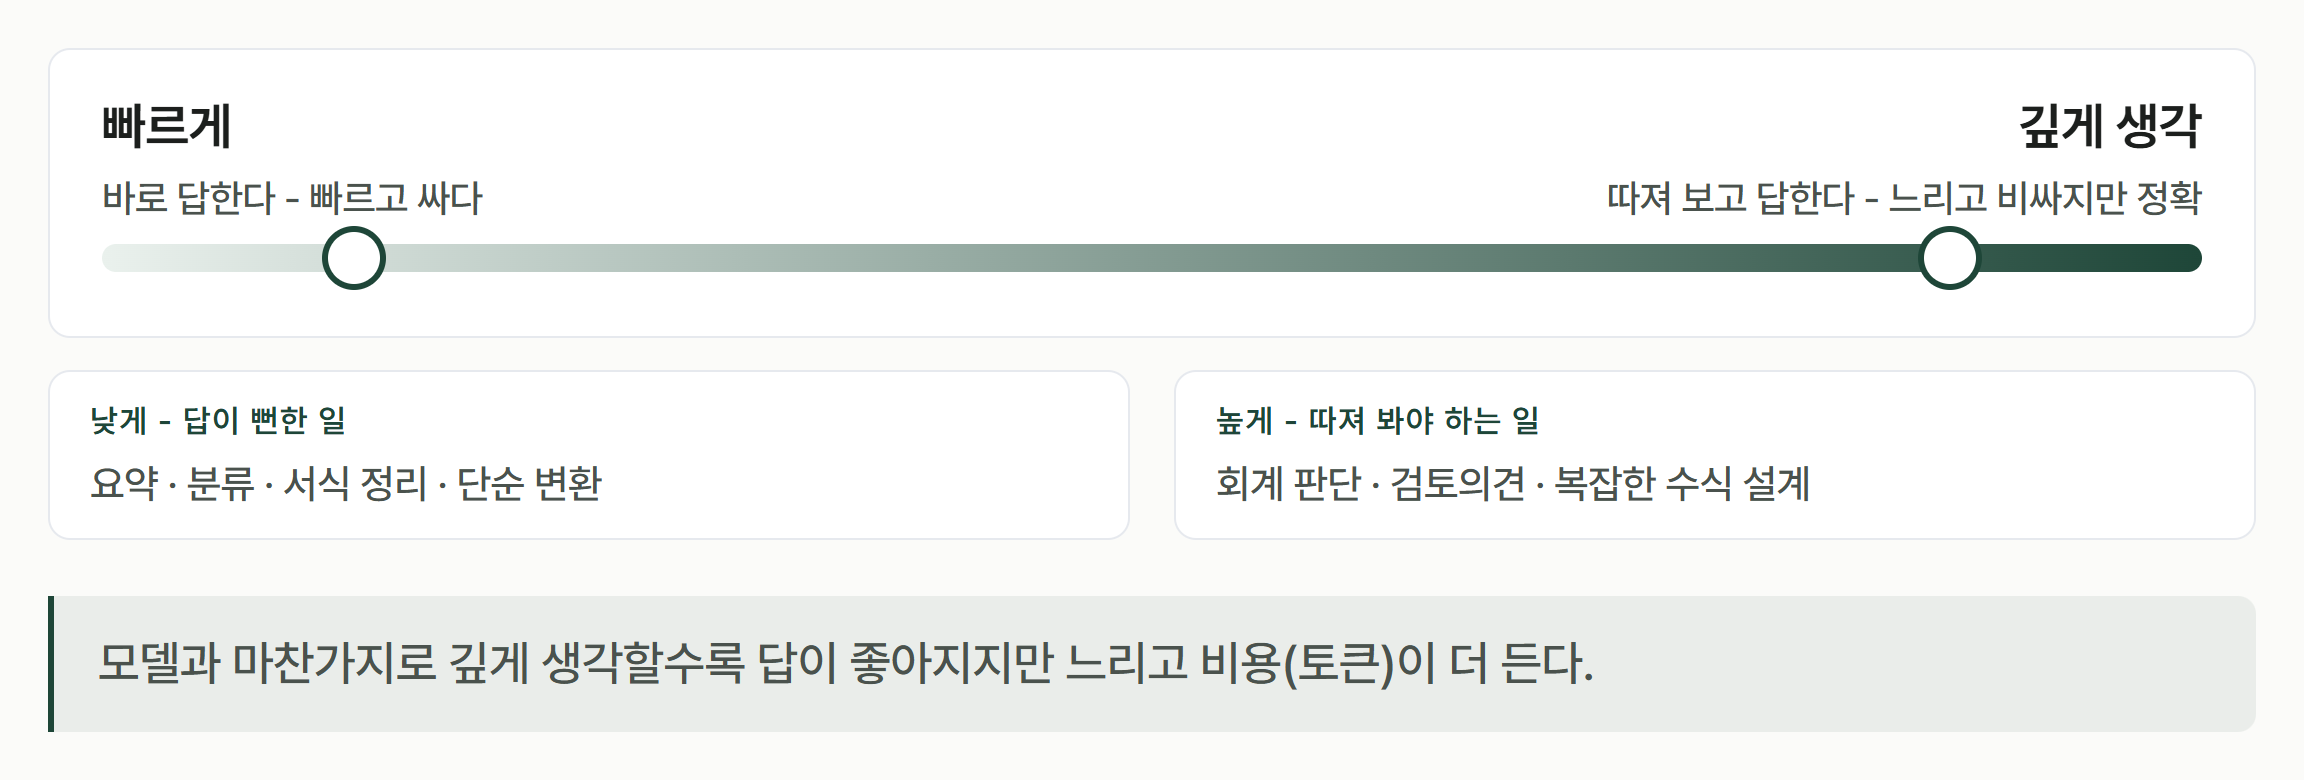 추론 수준은 얼마나 생각할지를 고르는 것
그림 위쪽 막대의 왼쪽 끝은 바로 답하는 쪽으로 빠르고 싸며, 오른쪽 끝은 따져 보고 답하는 쪽으로 느리고 비싸지만 정확합니다. 아래 두 칸은 수준을 고르는 기준으로, 요약, 분류, 서식 정리, 단순 변환처럼 답이 뻔한 일은 낮게 두고 회계 판단, 검토의견, 복잡한 수식 설계처럼 따져 봐야 하는 일은 높게 둡니다.
모델 등급과 마찬가지로 깊게 생각할수록 답이 좋아지지만, 시간이 더 걸리고 비용(토큰)이 더 듭니다. 실제로 같은 모델도 생각을 더 시키면 시험 점수가 오르는데, 이 장 뒤쪽의 종합 벤치마크에서 숫자로 확인할 수 있습니다. 생각에도 비용이 드는 이유는 1.3장의 토큰에서 다루고, 클로드 엑셀 채팅창에서 이 수준을 고르는 자리는 4.4장에서 살펴보겠습니다.
7. 대표 모델과 벤치마크
모델을 만드는 대표적인 회사는 다음 세 곳입니다(2026년 9월 기준, 수시로 바뀜).
| 회사 | 서비스 | 대표 모델 | 강점 |
|---|---|---|---|
| 앤트로픽(Anthropic) | 클로드 | Fable 5.1, Opus 5, Sonnet 5, Haiku 4.5 | 코딩, 엑셀 실무, 회계·재무 분야 |
| 오픈AI(OpenAI) | 챗GPT | GPT-6 Astra, GPT-5.6(Sol·Terra·Luna) | 가장 넓은 사용자, 범용성 |
| 구글(Google) | 제미나이 | Pro, Flash(최신 3.8 Flash) | 긴 문서, 속도, 구글 서비스 연동 |
이 밖에 xAI의 그록, 딥시크, 메타의 라마 등이 있는데, 이름만 알아 두면 충분합니다. 회계·재무 분야에서는 벤치마크 점수로 보나 실무자들의 체감으로 보나 지금은 클로드가 가장 좋은 성능을 보이며, 이 시리즈가 클로드를 쓰는 이유도 여기에 있습니다.
7.1. (참고) 회계·재무 벤치마크
벤치마크(Benchmark)는 정해진 문제 세트로 채점한 표준 시험 점수입니다. 회계·재무에 가까운 시험 두 가지의 결과는 다음과 같습니다(Vals AI, Excel Modeling 2026.9.15 · Tax Agent Bench 2026.9.16 갱신, 정답률 %).
| 엑셀 재무모델링 | 점수 | 세무 리서치 | 점수 |
|---|---|---|---|
| Claude Fable 5 | 73.7 | Claude Fable 5.1 | 77.6 |
| Claude Opus 5 | 73.6 | Claude Opus 5 | 75.1 |
| GPT-5.6 Sol | 72.3 | GPT-5.6 Sol | 67.9 |
| Claude Opus 4.8 | 69.4 | Gemini 3.8 Flash | 66.8 |
| GPT-6 Astra | 69.1 | Claude Sonnet 5 | 58.6 |
| Gemini 3.8 Flash | 68.4 | GPT-6 Astra | 55.7 |
| Claude Sonnet 5 | 65.0 |
엑셀 재무모델링은 추정 재무제표와 가치평가 모델을 엑셀로 만드는 시험으로, 투자은행·사모펀드의 주니어 수준 과제입니다. 세무 리서치는 미국 법인세, 파트너십, 이전가격 실무 질문에 법령을 찾아 답하는 시험입니다.
두 표를 나란히 보면 분야마다 순위가 다르다는 점이 보입니다. 예를 들어 GPT-6 Astra는 아래의 종합 점수에서 공동 1위지만, 세무 리서치에서는 55.7%로 낮습니다. 엑셀 재무모델링에서는 1위 모델도 수식과 서식 점검은 80~88%를 통과하는 반면, 숫자가 맞는지는 63%만 통과한다는 점을 눈여겨볼 만합니다. 즉 숫자 정확도가 병목이며, 이 시리즈가 7.1장에서 '숫자는 수식과 코드로 고정하고 사람이 검증한다'는 결론으로 가는 이유도 여기에 있습니다.
7.2. (참고) 종합 벤치마크
수학, 과학, 코딩, 실무 과제 등 10개 평가를 합친 종합 지수도 있습니다(Artificial Analysis Intelligence Index v4.3, 2026.9.19 조회).
| 모델 | 회사 · 추론 수준 | 점수 |
|---|---|---|
| Claude Fable 5.1 | 앤트로픽 · 최대 | 53 |
| GPT-6 Astra | 오픈AI · 최대 | 53 |
| Claude Opus 5 | 앤트로픽 · 최대 | 51 |
| GPT-5.6 Sol | 오픈AI · 최대 | 47 |
| Gemini 3.8 Flash | 구글 · 높음 | 41 |
| Claude Sonnet 5 | 앤트로픽 · 최대 | 38 |
| GPT-5.6 Luna | 오픈AI · 최대 | 38 |
구글은 최상위 Pro 모델의 출시가 늦어지고 있어 Flash가 대표로 올라와 있습니다. 같은 모델도 추론 수준에 따라 점수가 달라지는데, Claude Opus 5는 max 51, xhigh 50, high 48이고 GPT-6 Astra는 max 53, high 51, medium 50입니다. 6절에서 설명한 '생각을 더 시키면 답이 좋아진다'는 점이 숫자로 드러나는 대목입니다.
7.3. (참고) 국내 모델과 소버린 AI
해외 3사 외에 국내 모델도 있으며, 이런 흐름을 흔히 소버린 AI(Sovereign AI) 라고 부릅니다. 소버린 AI는 한 나라의 데이터와 법률, 문화의 주권을 지키는 독자적인 AI를 뜻하며, 쉽게 말해 우리 데이터를 우리 땅 안에서 처리하자는 취지입니다.
| 회사 | 모델 | 특징 |
|---|---|---|
| LG AI연구원 | 엑사원(EXAONE) | 한국어·영어 이중 언어, 오픈소스, 사내 설치에 강점 |
| 네이버 | 하이퍼클로바X(HyperCLOVA X) | 국내 법령·행정 데이터 학습, 국내 제도·세무 문맥 |
| 업스테이지 | 솔라(Solar) | 작고 빠른 경량 모델, 영수증·계약서 문서 인식 |
한국 특화 모델이 따로 주목받는 이유는 두 가지입니다. 첫째, 우리 고유의 세법, 회계 관행, 행정 서식 같은 국내 맥락은 해외 빅테크 모델이 충분히 이해하기 어렵습니다. 둘째, 망분리 같은 보안 규제 때문에 해외 서버로 보낼 수 없는 민감한 재무 자료와 내부 원장이 있는데, 국내 모델은 이런 자료를 사내 서버 안에서 처리할 길을 열어 줍니다.
정리
- AI 안에 생성형 AI가, 그 안에 글을 만드는 LLM이 있습니다. 알파고가 고르는 AI라면 생성형 AI는 만드는 AI입니다.
- LLM은 사전학습한 데이터로 다음 말을 확률로 고르는 모델이라, 최신·사내 정보를 모르고 답이 매번 조금씩 다릅니다.
- AI는 엑셀에 직접 손대지 않고 코드를 글로 쓰며, 실행은 컴퓨터가 합니다.
- 모델은 앱 뒤의 두뇌이고, 일의 무게에 맞춰 모델 등급과 추론 수준을 고릅니다. 일상 실무는 대부분 표준 모델로 충분합니다.
지금까지 생성형 AI와 LLM, 모델과 추론 수준을 살펴보았습니다. LLM은 학습하지 않은 것을 모르므로, 다음 1.2장에서는 모르는 것을 알려 줄 때 채팅창 위에서 쓰는 세 가지 말인 프롬프트와 컨텍스트, 마크다운을 살펴보겠습니다.
이 가이드 그대로 팀·조직 교육이 필요하신가요? 실무자 눈높이의 강의·워크숍으로 진행합니다.