가이드 › 1장. AI 핵심 용어
토큰, 컨텍스트 윈도우, 할루시네이션
AI 사용량을 재는 토큰, 한 채팅창의 용량인 컨텍스트 윈도우, 그럴듯한 오답인 할루시네이션을 실무에서 조심할 점 중심으로 정리합니다.
이 장에서 할 일
토큰이 무엇이고 언제 닳는지, 구독 한도와 API 요금이 어떻게 매겨지는지 이해합니다. 컨텍스트 윈도우가 찼을 때 생기는 문제와 할루시네이션을 줄이는 방법을 익힙니다.
AI를 실무에 오래 쓰다 보면 한 시간째 이어 온 대화에서 처음에 부탁한 표 양식을 AI가 어느새 잊어버리거나, 한창 일하는 중에 "사용량 한도에 도달했습니다"라는 메시지가 뜨거나, 자신 있게 인용한 기준서 문단이 실제로는 없는 경우를 겪게 됩니다. 세 가지는 서로 다른 문제처럼 보이지만 모두 AI가 글을 읽고 쓰는 방식에서 비롯되며, 이를 이해하는 데 필요한 용어가 토큰, 컨텍스트 윈도우, 할루시네이션입니다.
이번 장에서는 세 용어의 뜻은 짧게 설명하고, 실무에서 무엇을 조심해야 하는지에 무게를 두어 차례로 살펴보겠습니다.
1. 토큰
토큰(Token) 은 AI가 글을 읽고 쓰는 말의 조각이자, 요금과 사용량 한도가 매겨지는 단위입니다. 쉽게 말해 전기를 kWh로 재듯 AI 사용량은 토큰으로 재며, 다음 절에서 살펴볼 한 채팅창의 기억 용량도, 요금도, 구독 한도도 모두 토큰 단위로 매겨집니다.
앞 장까지 4천 토큰, 100만 토큰 같은 표현이 몇 번 나왔는데, 도입에서 두 번째로 든 "사용량 한도에 도달했습니다"라는 메시지도 결국 이 토큰을 다 썼다는 뜻입니다.
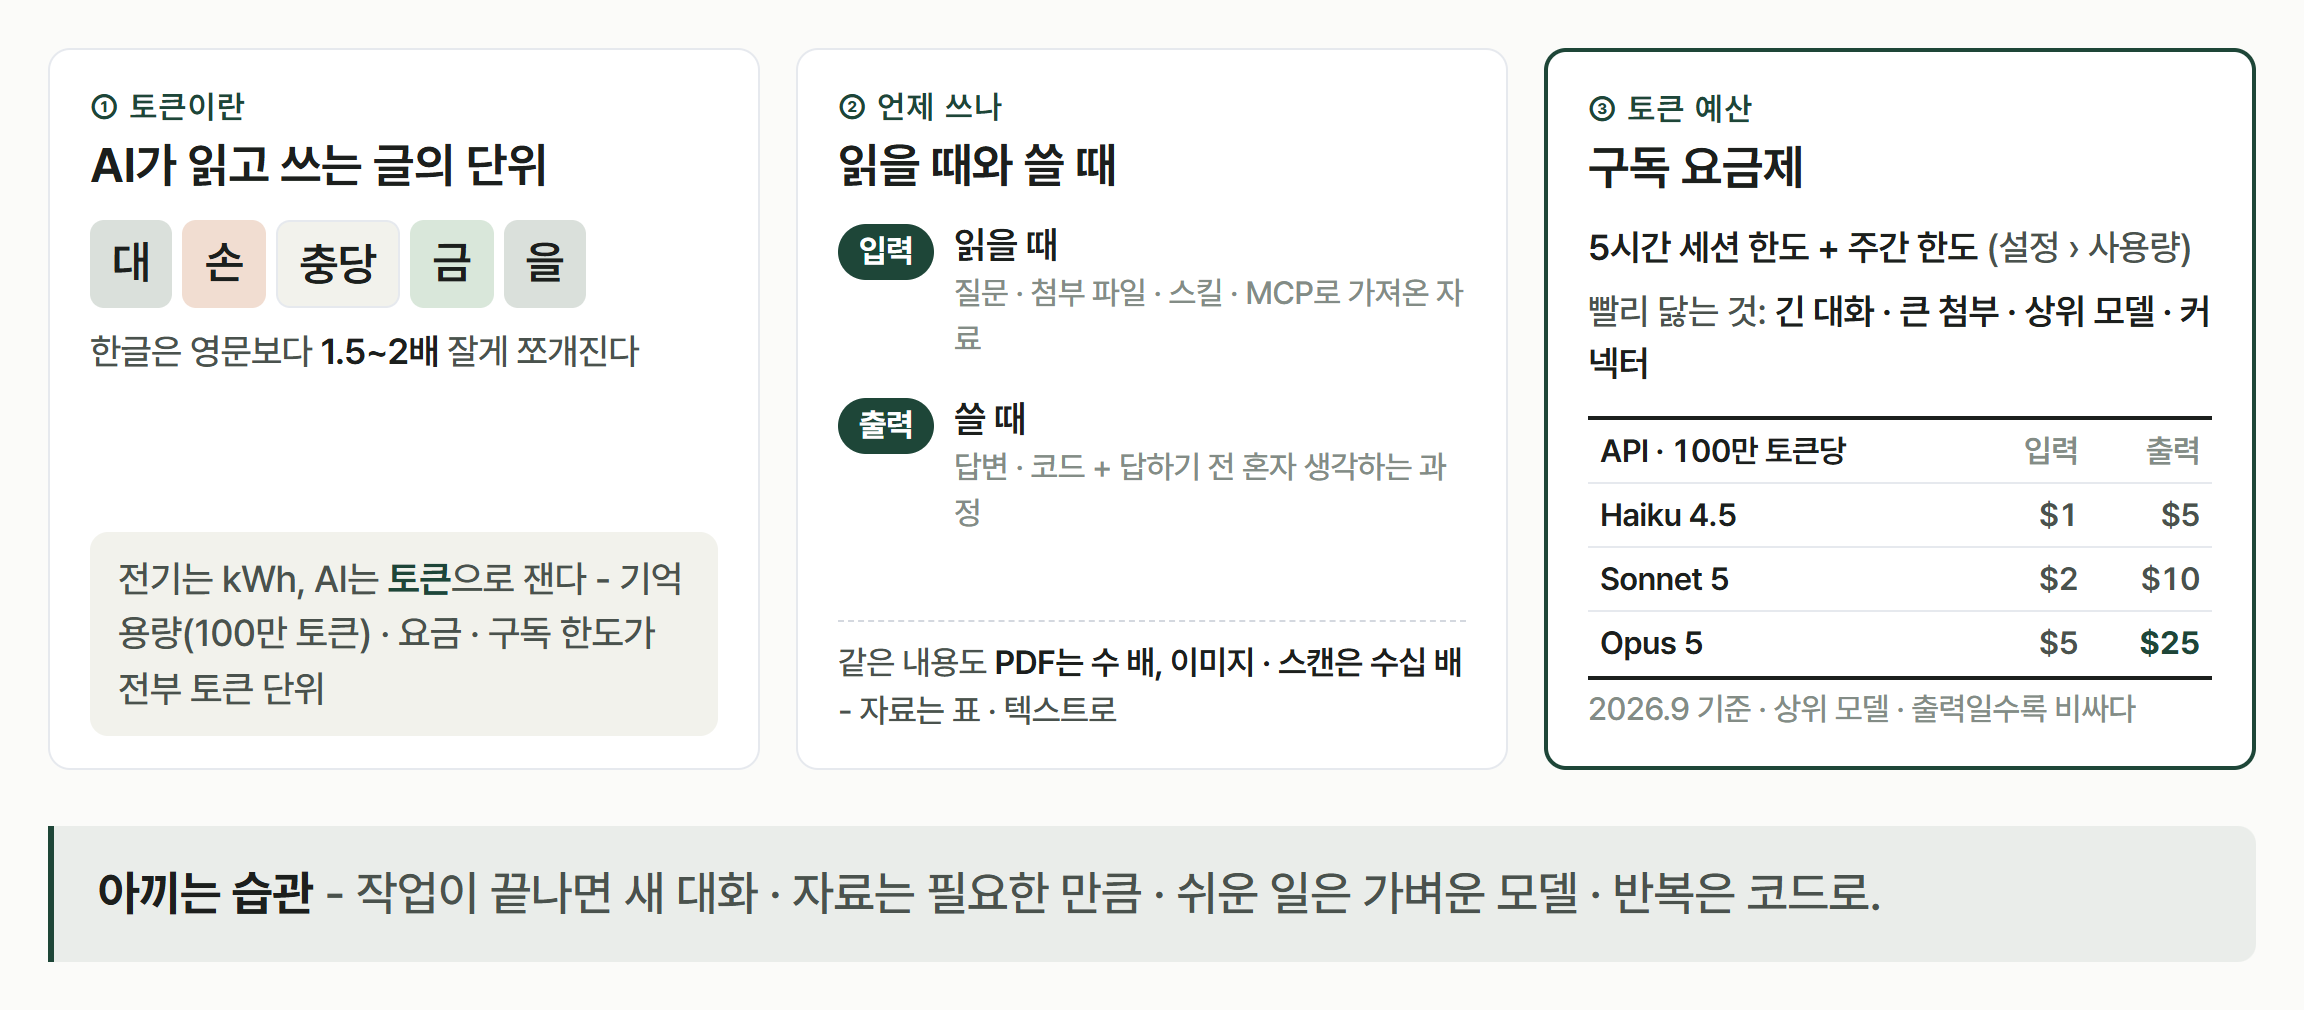 토큰, AI 사용량을 재는 단위
그림은 세 칸으로 구성되어 있으며, 이 절에서는 각 칸의 내용을 차례로 풀어 보겠습니다.
- 왼쪽: 토큰이 무엇인지
- 가운데: 토큰이 언제 쓰이는지
- 오른쪽: 그 사용량에 한도와 값이 어떻게 매겨지는지
1.1. 글은 조각으로 쪼개진다
AI는 글을 글자 단위도 단어 단위도 아닌 조각 단위로 읽는데, 예를 들어 "대손충당금을"은 '대', '손', '충당', '금', '을'처럼 여러 조각으로 나뉠 수 있습니다.
모델이 글을 조각내는 방식은 영어 중심으로 짜인 경우가 많아, 같은 뜻이라도 한국어가 영어보다 대체로 1.5~2배 잘게 쪼개지며 그 차이의 크기는 모델마다 다릅니다. 그렇다고 한국어 사용을 피할 필요는 없고, 긴 한국어 자료를 넣을 때 그만큼 여유를 잡아 두면 됩니다.
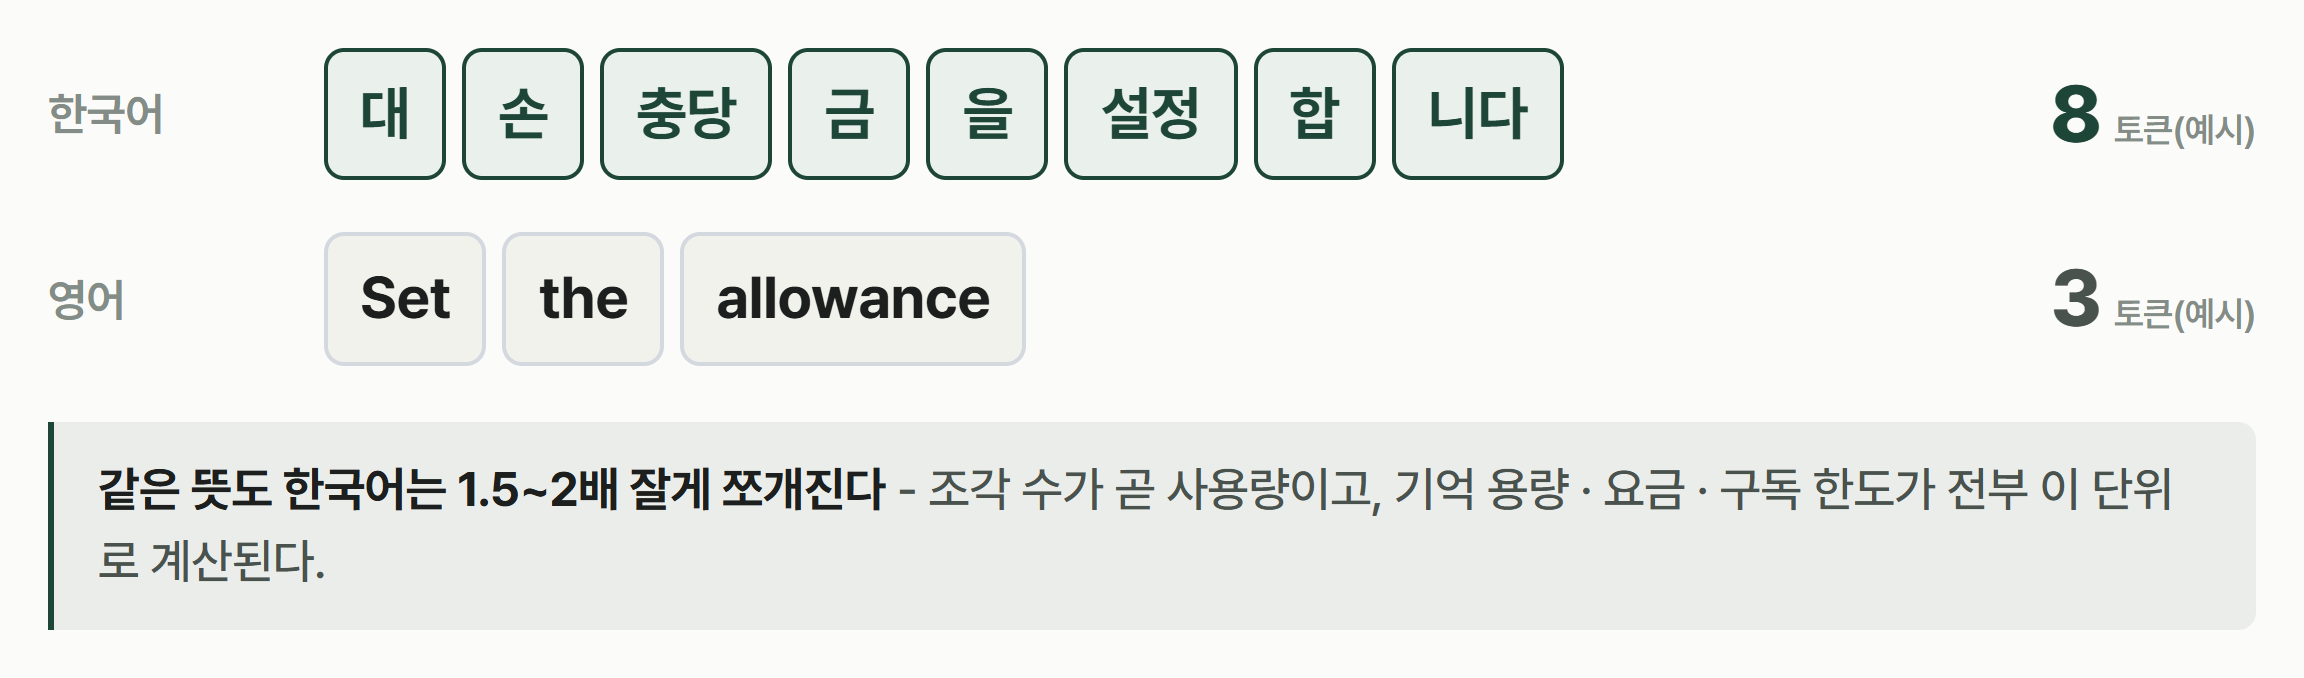 같은 뜻도 한국어는 더 잘게 쪼개진다, 조각 수가 곧 사용량이다
1.2. 언제 닳나
토큰은 AI가 글을 읽을 때와 쓸 때 모두 닳습니다.
-
입력(읽을 때): 내가 입력한 질문, 첨부한 파일, 스킬, MCP로 가져온 자료를 AI가 읽을 때 듭니다.
-
출력(쓸 때): 답변과 코드를 쓸 때, 그리고 답하기 전에 혼자 생각하는 과정에서 듭니다.
생각하는 과정에도 토큰이 드는 이유는 AI가 글을 써 내려가는 방식으로만 생각할 수 있기 때문입니다. '생각 중…'이 떠 있는 동안 AI는 사람처럼 머릿속으로 조용히 고민하지 않고, 우리에게 보이지 않는 연습장에 풀이 과정을 한 조각씩 적어 내려갑니다. 이 풀이도 AI가 쓴 글이므로 출력 토큰으로 계산되며, 1.1장에서 살펴본 추론 수준을 높이면 연습장이 길어지는 만큼 토큰도 더 듭니다.
반면 1.1장에서 살펴본 것처럼 AI가 쓴 코드를 컴퓨터가 실행하는 동안에는, 실행이 10초 걸리든 1분 걸리든 토큰이 들지 않습니다. 코드 실행은 모델이 관여하지 않고 컴퓨터가 맡는 일이기 때문입니다.
같은 내용이라도 어떤 형태로 건네느냐에 따라 드는 토큰의 양이 크게 달라집니다.
| 같은 자료를 건네는 방식 | 토큰 | 이유 |
|---|---|---|
| 마크다운·일반 텍스트·표 | 적다 | 글자와 최소한의 구조 기호뿐 |
| 텍스트가 살아 있는 PDF | 수 배 | 머리글·쪽번호 같은 잡음이 섞이고, 서비스에 따라 페이지 이미지까지 함께 읽는다 |
| 스캔 PDF·사진 | 수십 배 | 이미지로 들어가므로 글자 수와 무관하게 해상도에 따라 토큰이 매겨진다 |
토큰 열은 같은 분량을 기준으로 한 대략의 방향입니다. 실제 수치는 모델과 서비스마다 다릅니다.
따라서 자료는 가능하면 표와 텍스트로 건네는 것이 좋습니다. 두고두고 물어볼 스캔 계약서라면 AI에게 한 번 텍스트로 옮기게 하고 그 결과를 사람이 검토해 파일로 남겨 두면, 이후의 질문은 매번 적은 토큰으로 검토된 원문 위에서 처리됩니다.
1.3. 토큰 예산
토큰은 곧 예산이며, 클로드를 쓰는 방식에 따라 예산이 매겨지는 모양이 다릅니다(2026년 9월 기준, 수시로 바뀜).
구독 요금제는 월정액이지만 무제한으로 쓸 수는 없고, 5시간마다 초기화되는 세션 한도와 주간 한도가 함께 걸려 있어 이것이 곧 토큰 예산이 됩니다. 이 시리즈의 실습을 따라 하다가도 "사용량 한도에 도달했습니다"를 만날 수 있으며, 지금 얼마나 썼는지와 언제 초기화되는지는 설정 → 사용량에서 확인합니다. 한도를 빨리 닳게 하는 요인은 긴 대화, 큰 첨부 파일, 상위 모델, 그리고 커넥터로 가져오는 많은 자료의 네 가지입니다.
API는 개발자가 프로그램에서 모델을 부를 때 쓰는 방식으로, 쓴 만큼 돈을 내며 100만 토큰당 가격은 다음과 같습니다.
| 모델 | 입력 | 출력 |
|---|---|---|
| Haiku 4.5 | $1 | $5 |
| Sonnet 5 | $2 | $10 |
| Opus 5 | $5 | $25 |
표에서 보듯 상위 모델일수록 비싸고, 같은 모델에서도 출력이 입력보다 다섯 배 비쌉니다. 이 시리즈의 실습은 구독 요금제로 진행하므로 API 요금을 직접 낼 일은 없지만, 이 비율을 알아 두면 어떤 작업이 한도를 빨리 닳게 하는지 가늠하는 데 도움이 됩니다.
2. 컨텍스트 윈도우
토큰이 비용의 단위라면, 한 번에 올려 둘 수 있는 토큰의 양에도 한계가 있습니다.
컨텍스트 윈도우(Context Window) 는 한 채팅창에서 담을 수 있는 컨텍스트의 용량입니다. 쉽게 말해 AI의 작업 기억을 담는 '책상'이라고 생각하면 되며, 내가 보낸 메시지와 붙인 파일, 설정해 둔 지침, AI가 앞서 한 답까지 모두 이 책상 위에 올라갑니다.
컨텍스트 윈도우는 그동안 크게 넓어졌습니다. 챗GPT가 처음 나온 초창기(2022~2023년)에는 약 4천 토큰, A4 몇 장 분량이어서 PDF는 몇 장 이상 붙일 수 없었고 대화가 조금만 길어져도 더 이어지지 않았습니다. 지금은 100만 토큰, 책 여러 권 분량까지 늘어나 웬만한 맥락은 모두 올려 둘 수 있습니다.
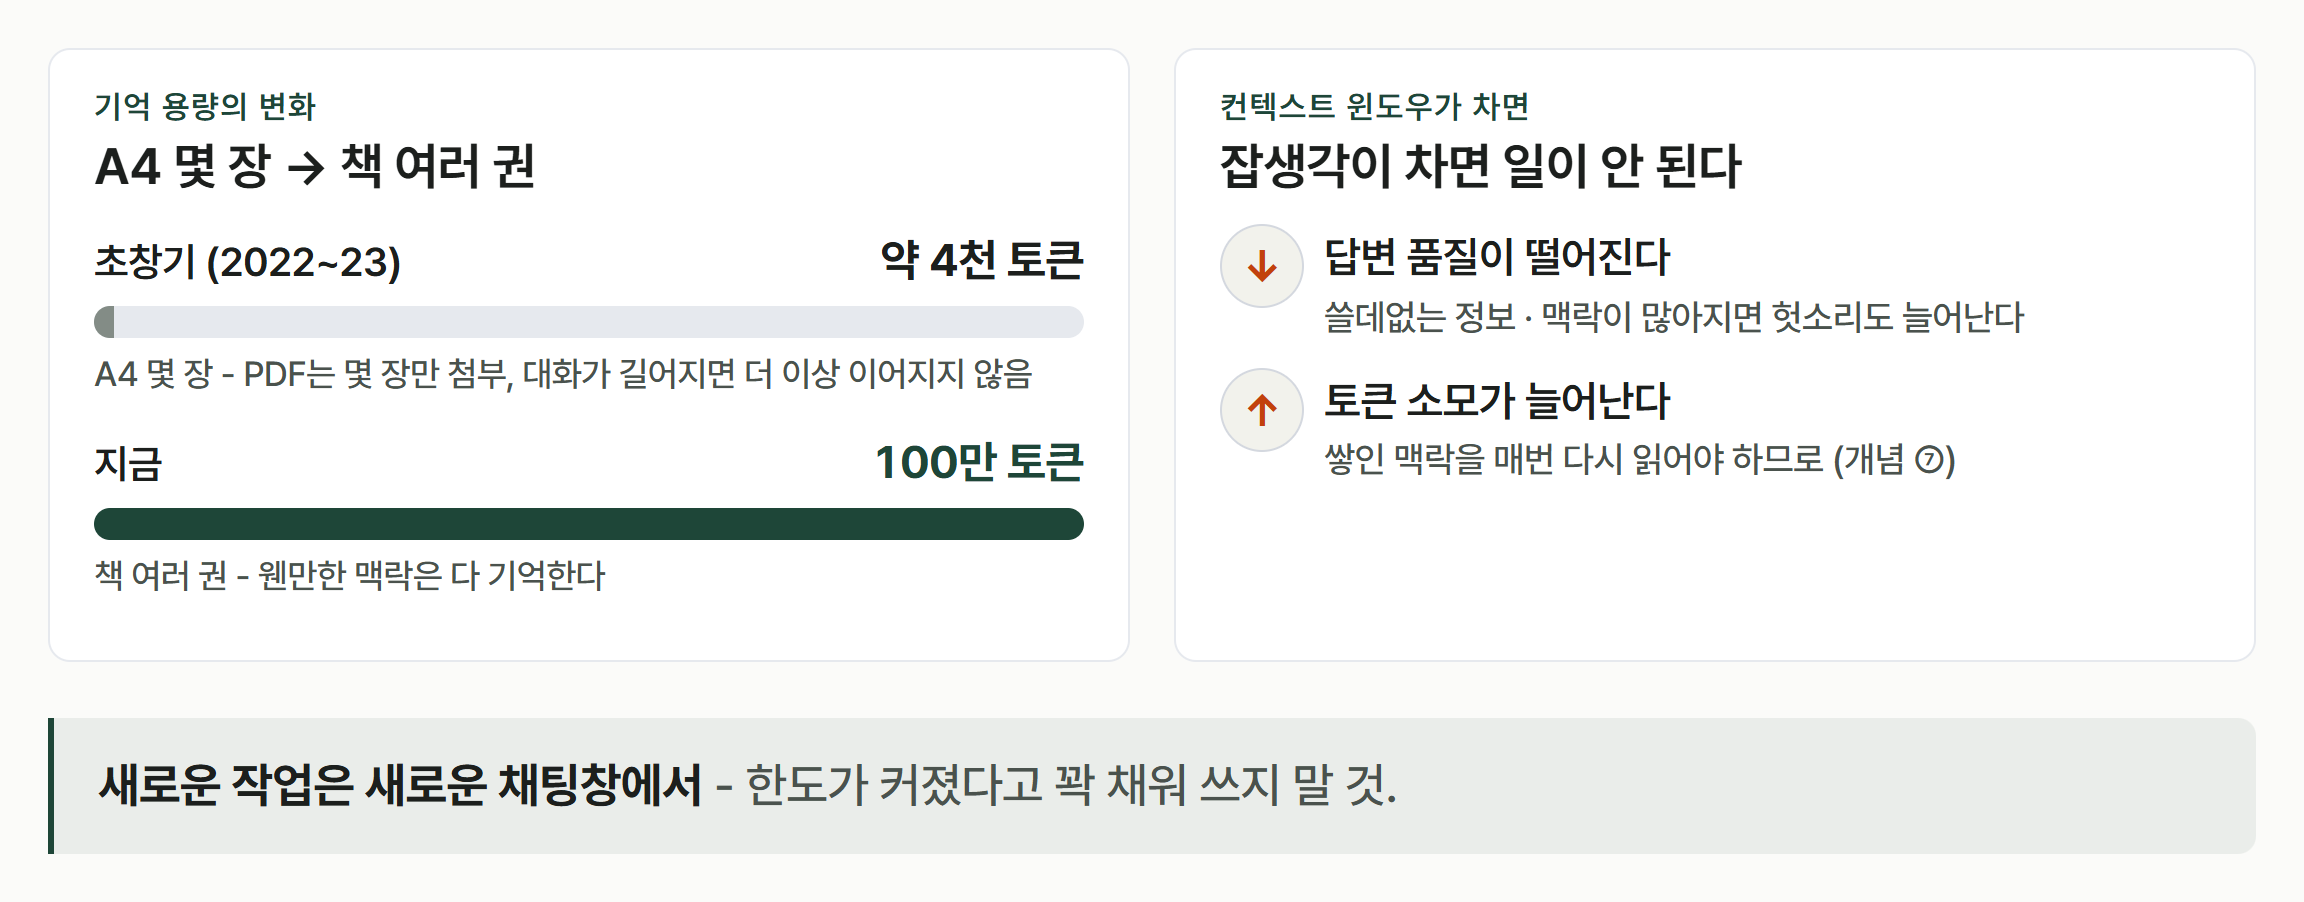 컨텍스트 윈도우, 한 채팅창에 담기는 용량
그림 왼쪽의 막대 두 개가 그 변화로, 4천 토큰 막대는 100만 토큰 막대 옆에서 거의 보이지 않을 만큼 짧습니다. 하지만 오른쪽 칸에서 보듯 용량이 넓어졌다고 문제가 사라지지는 않았으며, 컨텍스트 윈도우가 차면 답변 품질이 떨어지고 토큰 소모가 늘어납니다. 그 이유는 AI가 컨텍스트를 읽는 방식에 있습니다.
AI는 대화를 사람처럼 기억하지 않고, 답할 때마다 책상 위에 놓인 내용을 처음부터 다시 읽습니다.
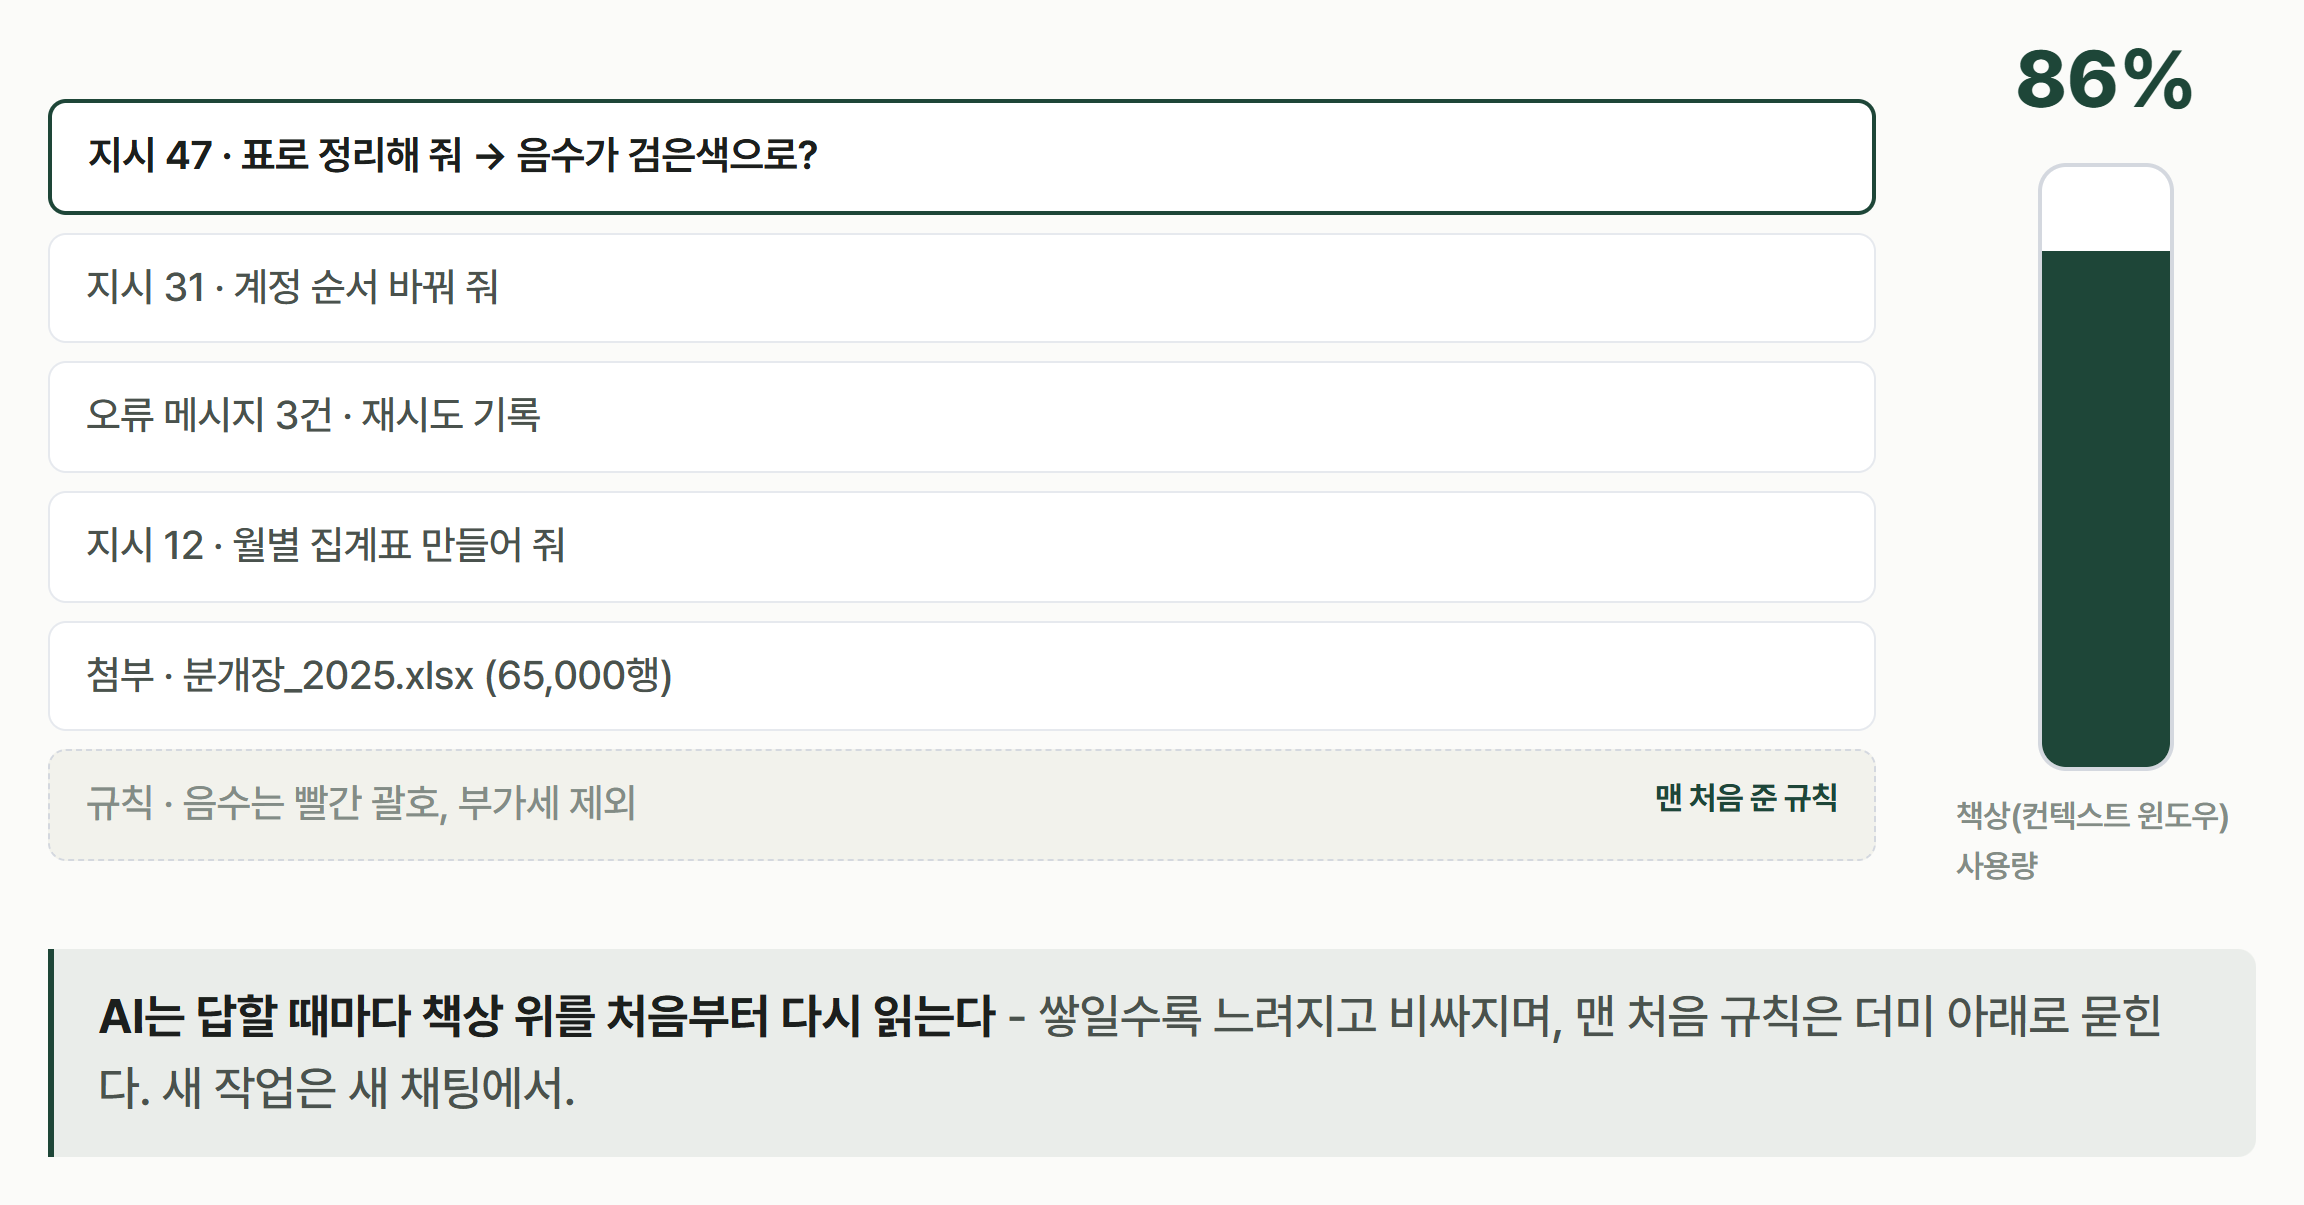 대화가 길어질수록 책상이 차고, 맨 처음 준 규칙은 더미 아래로 묻힌다
이 때문에 컨텍스트 윈도우가 찰수록 두 가지 문제가 함께 커집니다.
첫째, 답의 품질이 떨어집니다. 앞에서 시도했다가 버린 안이나 틀렸던 중간 결과가 치워지지 않고 남아 엉뚱한 답의 재료가 되고, 긴 대화의 초반에 준 지시는 뒤로 갈수록 덜 지켜집니다. 서비스에 따라서는 컨텍스트 윈도우가 넘치기 직전에 앞부분을 요약해 정리하면서 세부 조건이 빠지기도 하는데, 이 장 첫머리에서 든 '잊힌 표 양식'이 바로 이런 경우입니다. 잡생각이 많으면 일이 잘 안 되는 것은 사람이나 AI나 마찬가지입니다.
둘째, 토큰 소모가 늘어납니다. 한 줄짜리 질문을 던져도 AI는 그 앞의 긴 대화를 전부 다시 읽으므로, 대화가 길수록 한 번 묻는 데 드는 토큰이 많아지고 앞 절에서 설명한 한도도 그만큼 빨리 닳습니다.
컨텍스트 윈도우가 넓어졌더라도 꽉 채워 쓰지 말고, 새 작업은 새 채팅창에서 시작합니다. 실무에서 지킬 요령은 다음 세 가지입니다.
- 작업 단위마다 새 대화: 오전에 정산표를 다룬 대화에서 오후의 주석 작업까지 이어 가지 말고, 필요한 결론 몇 줄만 들고 새 대화로 옮깁니다.
- 필요한 시트와 범위만 전달: 엑셀은 워크북 전체를 건네기보다 '매출채권 시트의 A1:H200'처럼 좁혀 줄수록 컨텍스트가 깨끗하게 유지됩니다.
- 반복 요구는 대화 밖으로: 대화마다 첫머리에 붙여 넣던 양식 규칙은 지침이나 스킬로 고정해 둡니다. 이 둘은 1.4장에서 미리 살펴보고, 스킬은 3부에서 직접 만듭니다.
셋 중 하나만 고르라면 저는 첫째를 권합니다. 어지러워진 대화를 정리하는 가장 확실한 방법은 새 대화로 옮겨 가는 것이고, 그때 무엇을 들고 갈지 고르는 과정에서 작업의 결론도 한 번 정리되기 때문입니다.
3. 할루시네이션
하지만 컨텍스트에 근거가 없을 때도 AI는 '모르겠다'며 멈추지 않습니다.
할루시네이션(환각, Hallucination) 은 사실이 아닌 것을 사실처럼 그럴듯하게 지어내는 현상입니다. AI에게는 속일 의도가 없다는 점에서 거짓말과는 다르며, 사실을 확인해서 말하지 않고 가장 그럴듯한 다음 말을 확률로 뽑는 원리가 낳은 부작용으로 이해하면 됩니다.
예를 들어 재고자산 평가손실을 환입할 때의 근거 문단을 물었다고 해 보겠습니다.
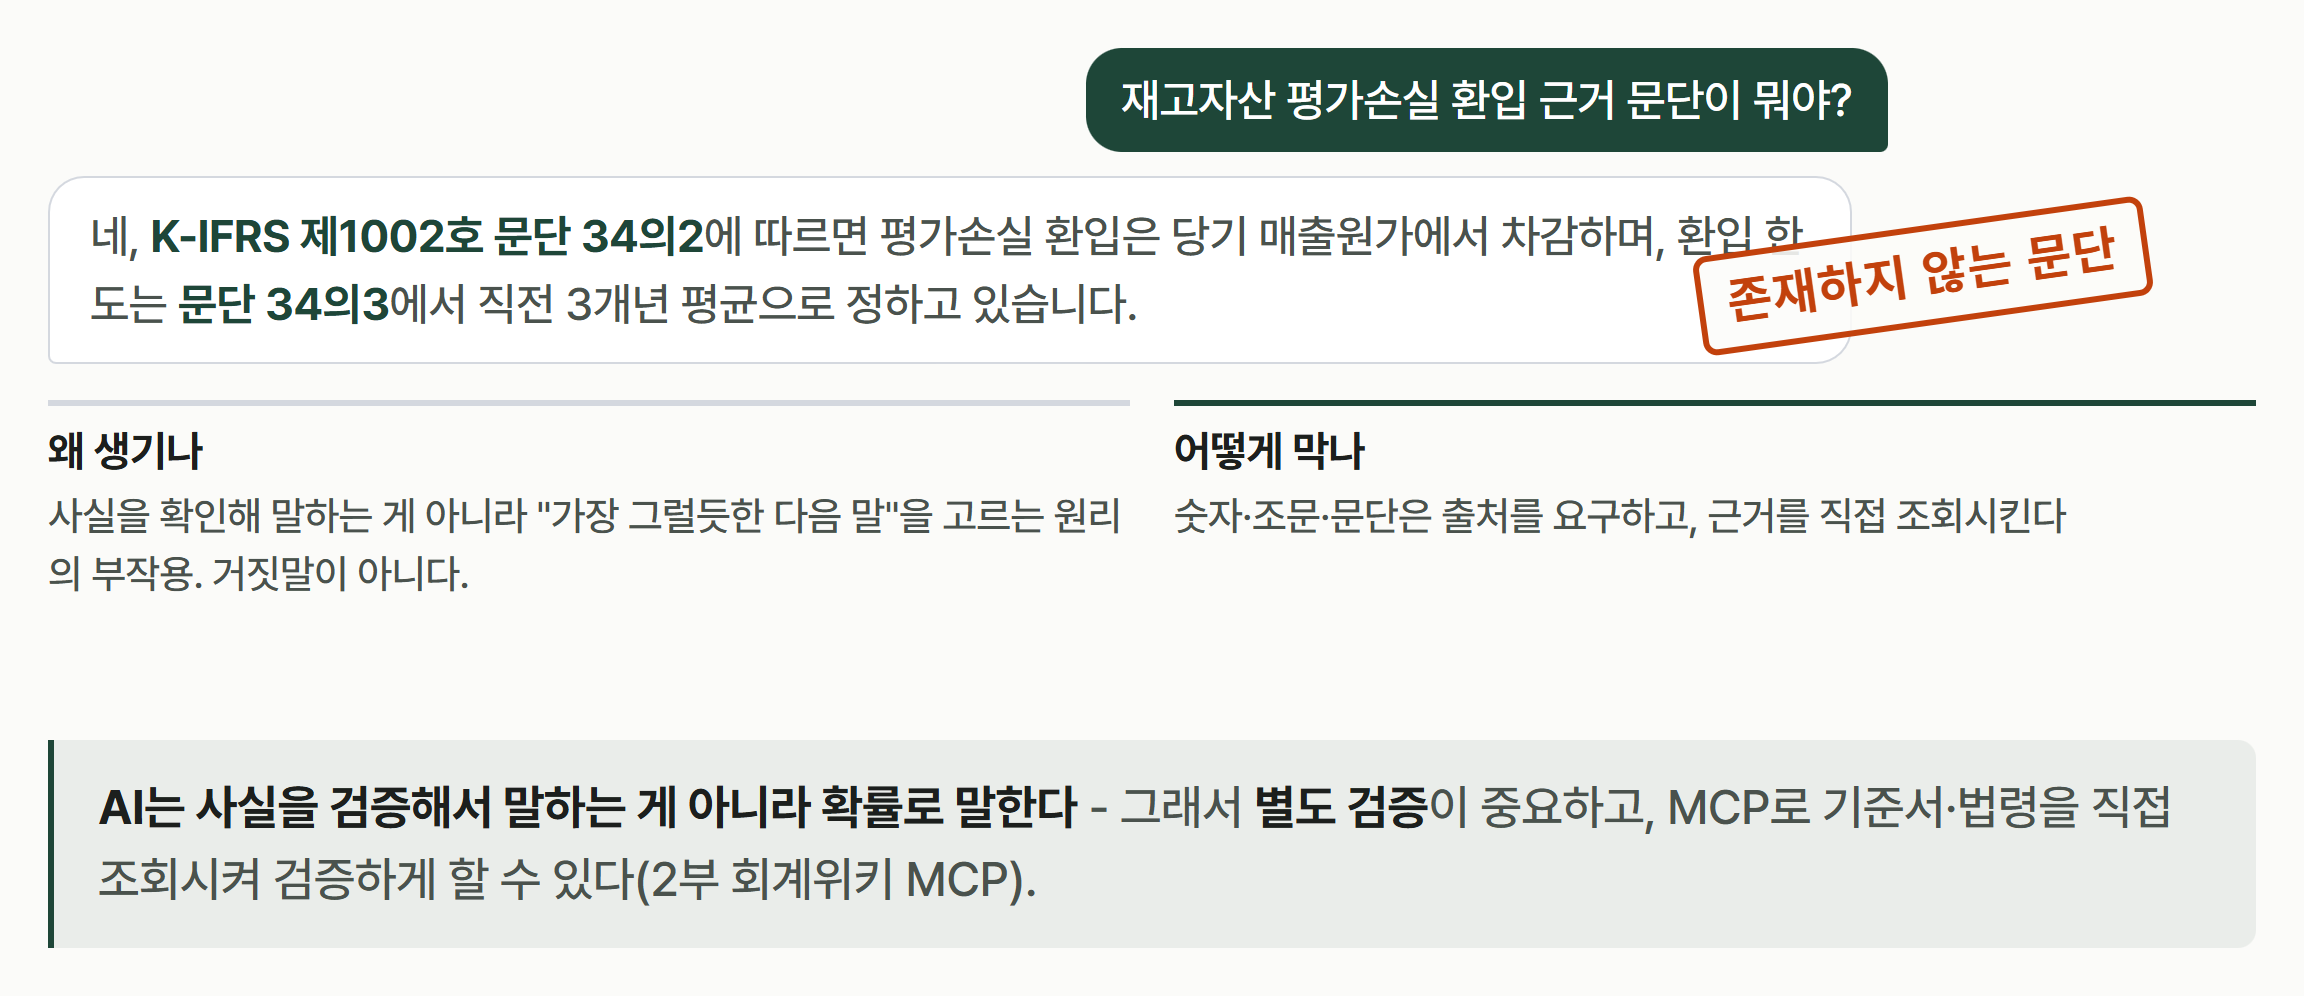 할루시네이션, 모르는 것도 그럴듯하게 지어낸다
그림 위쪽은 질문과 답입니다. "재고자산 평가손실 환입 근거 문단이 뭐야?"라는 질문에 AI는 K-IFRS 제1002호 문단 34의2에 따르면 평가손실 환입은 당기 매출원가에서 차감하고, 환입 한도는 문단 34의3에서 직전 3개년 평균으로 정한다고 답했습니다. 문단 번호 형식도 맞고 말투도 자신 있지만, 제1002호에는 문단 34의2도 34의3도 없으며 그림에 도장이 찍힌 대로 존재하지 않는 문단입니다. 그림 아래 두 칸은 이런 일이 왜 생기는지와 어떻게 막는지를 보여 주며, 이 절의 나머지에서 차례로 다룹니다.
이런 일이 생기는 이유는 AI의 지식이 기준서를 한 권씩 꽂아 둔 서가보다는, 훈련 때 읽은 방대한 글에서 '어떤 말 뒤에 어떤 말이 오는가'의 패턴을 익혀 둔 것에 가깝기 때문입니다. 이 때문에 답을 만드는 과정에 '이 문단이 실제로 있는가'를 찾아보는 단계가 따로 없고, 컨텍스트에 원문이 없으면 익힌 패턴만으로 빈칸을 채웁니다. 훈련 이후에 개정된 내용이라면 이런 일이 더 쉽게 일어납니다.
회계 실무에서 이 원리가 특히 까다로워지는 곳은 '구조화된 인용'입니다. 질의회신 번호, 기준서 문단 번호, 법령 조항처럼 정해진 틀이 있는 인용은 AI가 수없이 본 패턴이라 틀 자체는 쉽게 만들어지지만, 그 번호가 가리키는 실제 문서가 무엇인지는 패턴 속에 들어 있지 않습니다. 따라서 근거가 생명인 조서와 검토의견에서는 이 확인을 건너뛰는 순간 사고로 이어집니다.
할루시네이션은 1.1장에서 살펴본, 같은 질문에도 답이 조금씩 달라지는 성질과도 구분해 둘 필요가 있습니다. 둘 다 같은 확률 원리에서 나오지만 현상은 달라서, 할루시네이션은 답이 흔들리지 않아도 틀릴 수 있는 그럴듯한 오답입니다. 다섯 번 물어 다섯 번 모두 똑같이 없는 문단을 댈 수도 있습니다.
할루시네이션을 줄이는 방법은 두 단계로 나눌 수 있습니다.
첫째, 숫자·조문·문단이 나오면 출처를 요구합니다. 다만 AI는 출처마저 그럴듯하게 지어낼 수 있으므로 출처를 달라는 요구만으로는 부족하며, 출처를 받고 원문에서 그 문단을 직접 확인하는 것까지가 한 세트입니다.
둘째, 근거를 기억에서 꺼내게 하지 말고 직접 조회하게 합니다. 즉, 원문을 책상 위에 올려 주고 그 안에서 답하게 하는 방식이며, 이때 '붙여 준 자료에 없으면 없다고 답하라'는 한 줄을 함께 주면 빈칸을 패턴으로 채우는 일이 한층 줄어듭니다. AI가 기준서나 공시를 직접 찾아보게 하는 통로인 MCP가 이 일을 맡습니다. MCP의 뜻은 1.4장에서, 회계위키 MCP를 연결해 기준서를 직접 조회시키는 방법은 2부에서 다룹니다(질문에 맞는 문서를 먼저 찾아 붙이는 RAG는 부록 A).
정리
- 토큰은 AI가 읽고 쓰는 말의 조각이자 요금·한도의 단위이고, 한국어와 이미지·스캔 자료는 더 많이 씁니다.
- 구독은 5시간 세션 한도와 주간 한도로, API는 100만 토큰당 가격으로 매겨지며 상위 모델과 출력이 비쌉니다.
- 컨텍스트 윈도우는 4천에서 100만 토큰으로 넓어졌지만, 차면 품질이 떨어지고 토큰이 늘어나므로 새 작업은 새 채팅에서 합니다.
- 할루시네이션은 확률 원리의 부작용이라 0이 되지 않으므로, 출처를 받아 원문을 확인하고 MCP로 근거를 직접 조회하게 합니다.
지금까지 토큰, 컨텍스트 윈도우, 할루시네이션을 살펴보았습니다. 다음 1.4장에서는 1부의 마지막 개념이자 이 시리즈의 핵심인 스킬과 MCP를 미리 살펴보겠습니다.
이 가이드 그대로 팀·조직 교육이 필요하신가요? 실무자 눈높이의 강의·워크숍으로 진행합니다.